この記事には楽天アフィリエイトの広告を含みます。 Amazonのアソシエイトとして、PROBEFOLIOは適格販売により収入を得ています。
すでにAWSでデータやアクセス権を管理している企業なら、エージェントをどこで動かし、どこへ記録を残すかが導入条件になります。モデルを選ぶことと、実行環境を選ぶことを分けて比較します。
この記事の目次
何が発表された?
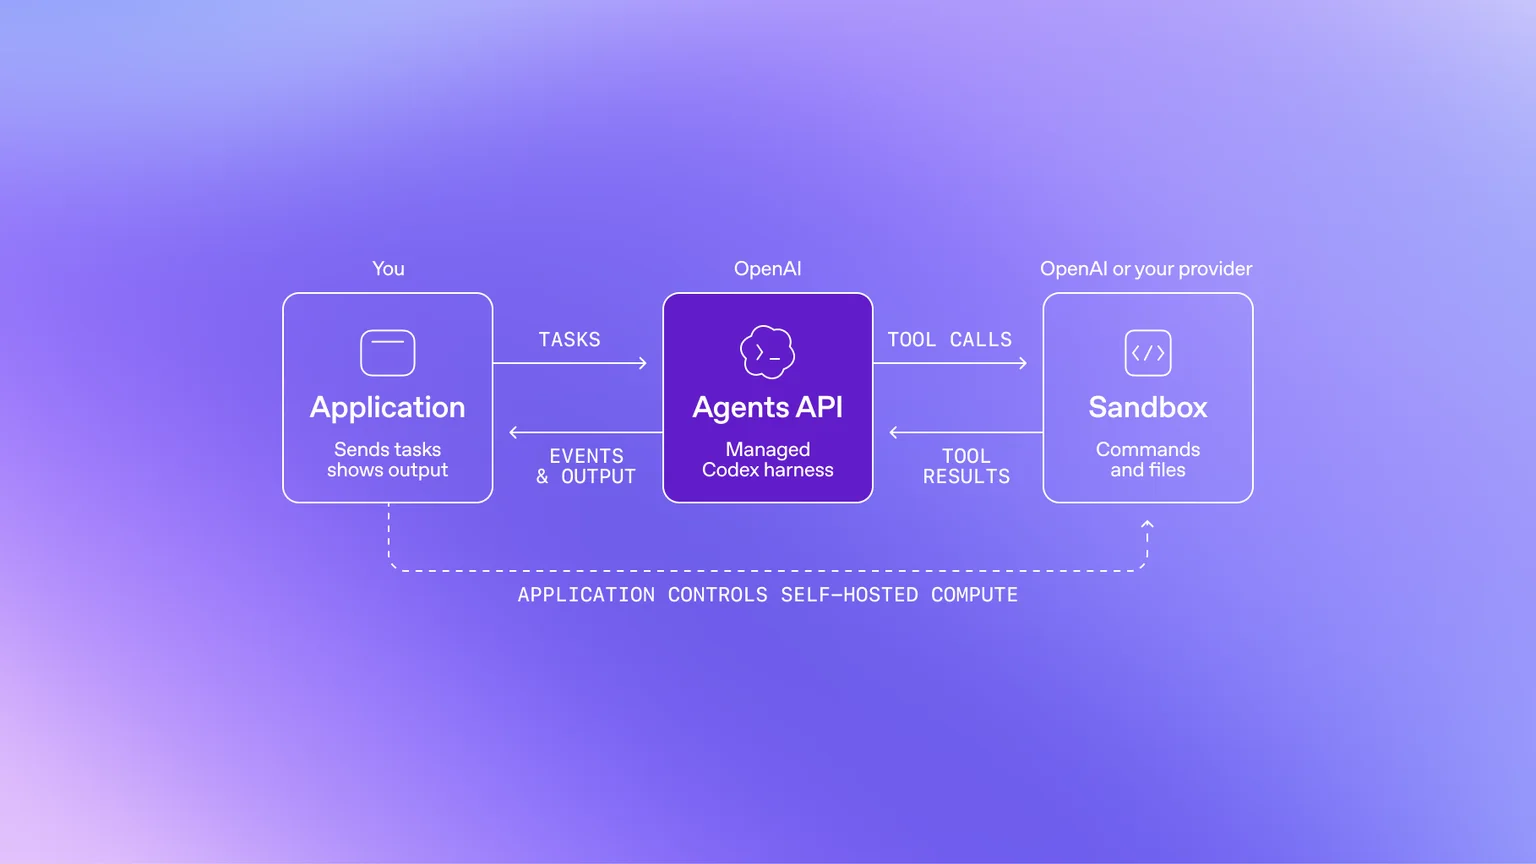
まず、前提となるAgents APIを、かんたんにおさらいします。OpenAIのコーディングAI「Codex」を動かしているのと同じハーネス(AIに道具と手順を与える仕組み)を、OpenAIが運用するサービスとして使えるAPIです。
詳しくは、Agents APIの記事にまとめています。
「Bedrock Managed Agents」は、これをAWSに合わせて作り直したものです。公式ドキュメントでは、OpenAIのエージェントのハーネスとモデルの推論を、Amazon Bedrockの上で動かすと説明されています。
ハーネスがエージェントの作業を取りまとめ、コマンドやツールの実行は、AgentCore Runtimeか、自前の計算環境で行います。
Agents APIとの違い
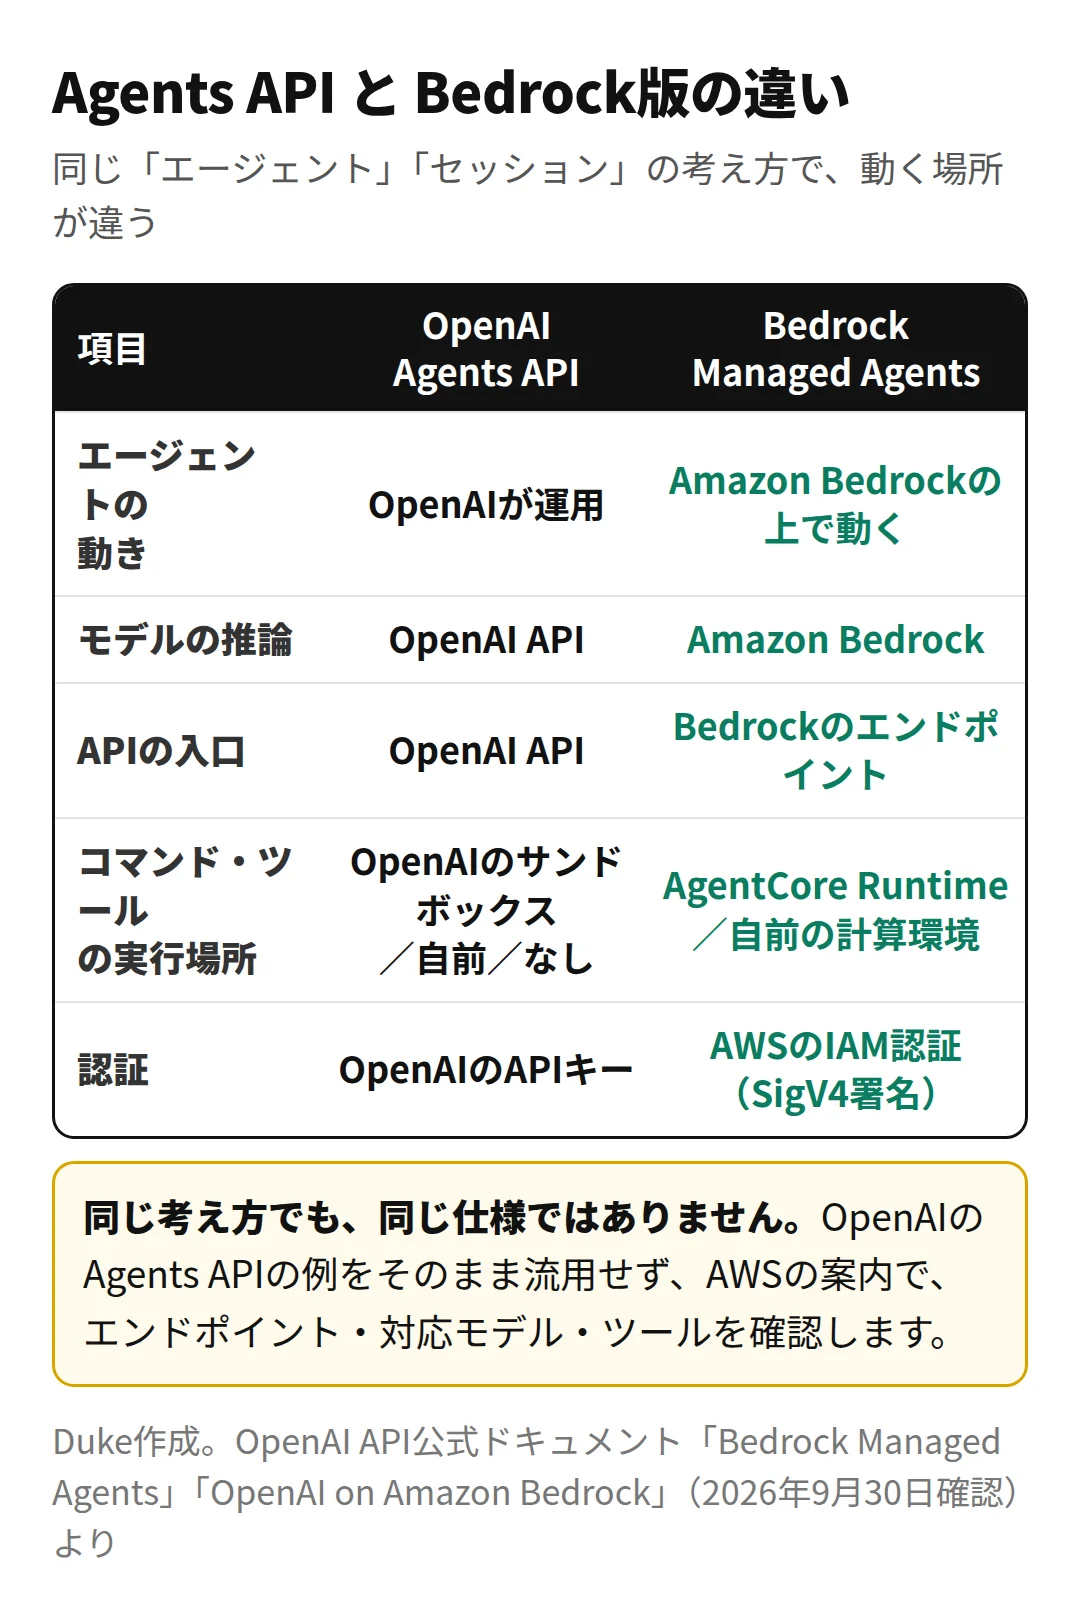
両方とも、「エージェント」と「セッション」という同じ考え方を使います。違いは、動く場所、認証、周辺サービスです。
OpenAIのAgents APIは、OpenAIが動かし、OpenAIのAPIキーで使います。実行環境は、OpenAIのサンドボックス、自前のサンドボックス、またはなしから選びます
Bedrock版は、AWSの中で動き、AWSのIAM認証(SigV4署名)で使います。実行環境は、AgentCore Runtimeか、自前の計算環境です
自前のサンドボックスを選んでも、OpenAIのAgents APIでは、ハーネスとモデルの推論はOpenAIのサービスを使います。変わるのはコマンドやツールの実行場所です。
Bedrock版はハーネスと推論をAmazon Bedrockで動かしますが、接続先のツールを含むデータの流れや、保存先・ログ・地域はAWSの案内と構成で別に確認します。
公式は、共通の考え方があっても、APIの仕様や機能が同じとは限らないと注意しています。OpenAIのAgents APIの例をそのまま流用せず、AWSの案内で、エンドポイント、対応モデル、ツール、環境の設定を確認するよう、書かれています。
すでにBedrockで使えるOpenAIのモデル
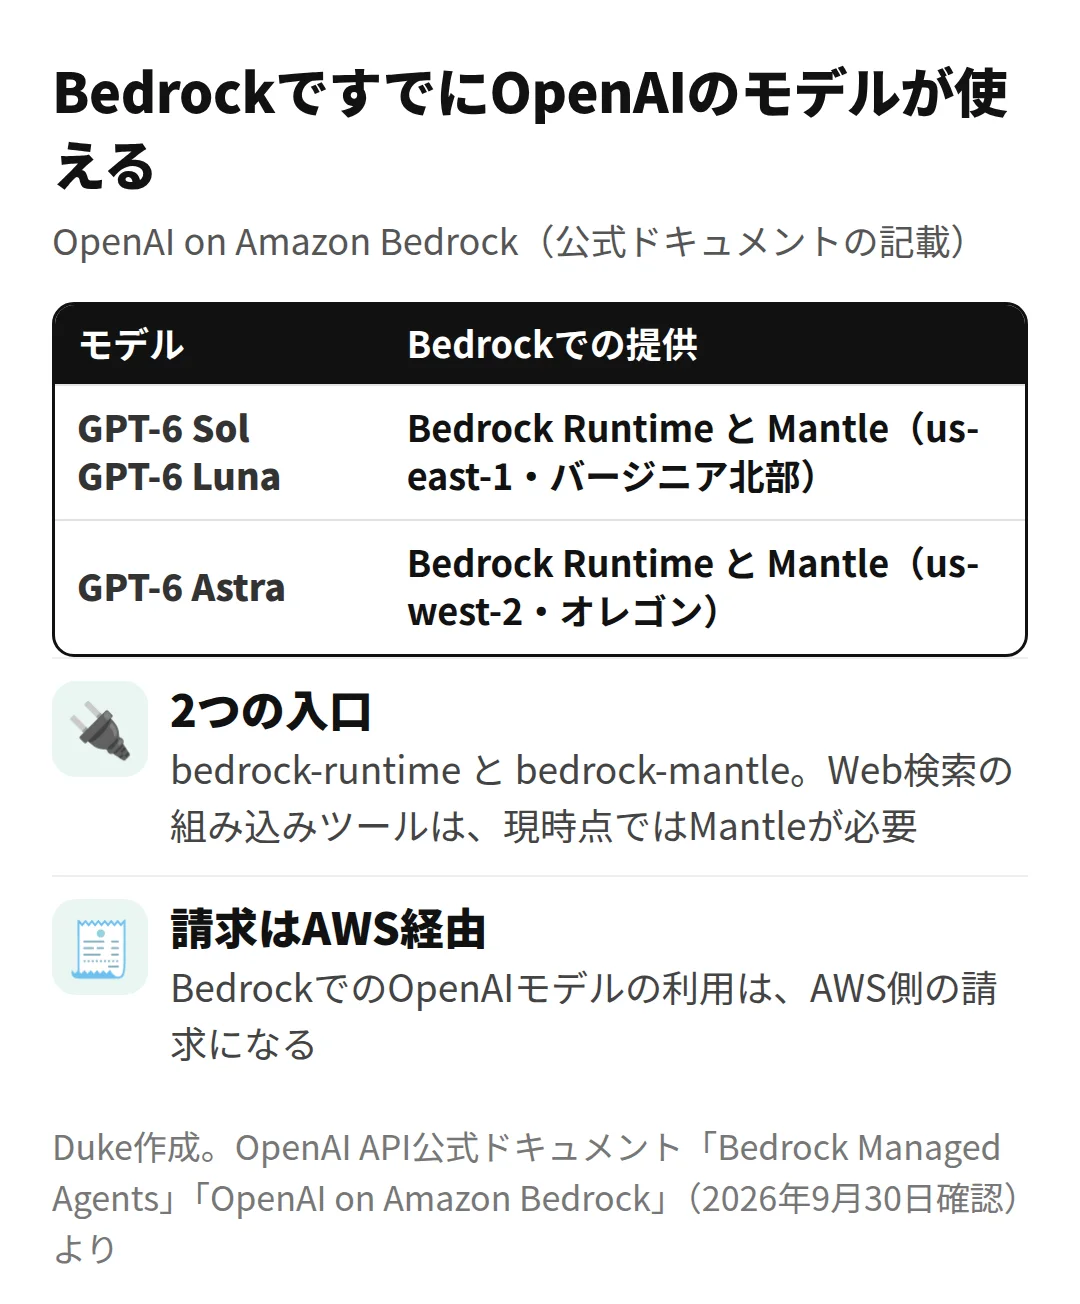
OpenAIのモデルは、すでにAmazon Bedrockでも使えます。
公式ドキュメントによると、GPT-6 SolとLunaは、Bedrock Runtimeと、us-east-1(バージニア北部)のMantleで使えます。
GPT-6 Astraは、Bedrock Runtimeと、us-west-2(オレゴン)のMantleで使えます。呼び出しには、OpenAIのSDKにBedrockのプロバイダーを組み合わせる方法もあります。
なお、BedrockでのOpenAIモデルの利用は、AWS経由で請求されます。
どちらを選ぶ?
選ぶ基準は、シンプルに「あなたの会社は、AWSを中心に動いているか」だと思います。
すでにAWSで開発・運用している:認証(IAM)、ネットワーク、請求、監査をAWSに集約できるBedrock版が、社内の手続きを進めやすそうです
OpenAIのAPIキーで、手軽に試したい:OpenAIのAgents APIのほうが、始めやすいはずです。データの所在地(米国のみ)や、ゼロデータ保持(非対応)の条件は、事前に確認します
データの扱いに条件がある:セッションの状態、実行ファイル、ログ、モデルの推論の扱いは、AWSの案内で確認する必要があります
AWSを使っている企業の比較項目
OpenAIのモデルをBedrockから呼び出すことと、Managed Agentsで実行基盤を用意することは、確認する項目が違います。前者はモデルの呼び出し、後者はツール実行や作業の継続を含むエージェントの環境です。サービス名が同じAWSの中にあっても、利用できる機能を個別に見ます。
たとえば、社内のデータがAWSにあり、アクセス記録や権限管理もAWS側で統一している企業なら、その既存の仕組みをどこまで使えるかが重要です。対象リージョン、ログ、接続できるツール、管理する担当、データが処理される場所を確認します。
新しく導入する場合は、代表的な1つの仕事で比較すると費用と運用の違いが分かります。回答の正しさだけでなく、失敗時の再試行、履歴の確認、接続を解除する方法まで含めて比較してください。Bedrock側の料金や上限はAWSの現行ドキュメントでも確認が必要です。
| 項目 | 確認する内容 |
|---|---|
| 計算とデータ | どこで処理し、どこに保存するか |
| 権限 | 誰の権限でツールを実行するか |
| ログ | 処理をどの管理画面で追えるか |
| 費用 | モデル利用と実行基盤を含めた合計 |
| 運用 | 止め方、再試行、担当者の引き継ぎ |
問い合わせを調べる仕事で、モデルと実行基盤を分ける
例えば、AWSに保存した問い合わせを調べて回答の下書きを作る仕事を考えます。AIモデルは本文を理解して回答を考え、エージェントの実行基盤は問い合わせの取得、ツールの呼び出し、途中状態の保存を扱います。モデルをBedrockで呼ぶだけで、後者の仕組みがすべて完成するわけではありません。
最初の比較では、保存済みの問い合わせを1件読む、必要な資料を探す、回答案を保存する、という小さな仕事を用意できます。AWS側で読めたデータと、実行履歴が記録された場所を照合します。顧客への送信を含める前に、下書きの正しさと処理の再開方法を確認する順番です。
問い合わせの回答案を作る例
- 入力を取得
必要な問い合わせと資料だけを読む。
- モデルが判断
内容を理解し、回答と必要な追加処理を考える。
- 実行基盤が保存
ツールの結果と回答案、処理の履歴を保存する。
Bedrockからモデルを呼ぶ機能と、複数の処理を続ける実行基盤を別々に選ぶ理由が分かります。
よくある疑問を、ここで。
使い始める前に、気になるところから。
Bedrockで動かすのと、ChatGPTを契約するのは同じですか?
AWS上で管理される開発用サービスと、ChatGPTの利用契約は別です。AWS側の提供状況、接続権限、実行環境、請求条件を確認します。
AWSのどの情報を読ませてもよいですか?
エージェントの役割に必要なデータと操作を決め、IAMなどの権限を確認します。手元の管理者アカウントの広い権限を、そのまま必要な権限としないでください。
この記事を共有する
商品情報の提供:Supported by Rakuten Developers
出典と、この記事について
公式資料や、記事で参照した発表・報道をまとめています。仕様や料金は、利用する前に最新の案内をご確認ください。
- OpenAI公式:Bedrock Managed AgentsとAgents APIの比較(新しいタブで開きます)
- OpenAI「DevDay 2026 の振り返り」(新しいタブで開きます)
- OpenAI公式:Amazon BedrockでのOpenAIモデル(新しいタブで開きます)
- OpenAI公式:Agents APIの概要(新しいタブで開きます)
- Dukeの元のニュース解説(新しいタブで開きます)
確認した内容と条件は本文に記載しています。結果や使い勝手は、資料や環境によって異なります。編集方針を読む
ぜひコメントください