この記事には楽天アフィリエイトの広告を含みます。 Amazonのアソシエイトとして、PROBEFOLIOは適格販売により収入を得ています。
Claude Opus 5.5(Anthropic)とGPT-6 Sol(OpenAI)は、どちらも2026年9月22日(米国時間)に発表された、仕事やプログラミングを任せるためのAIモデルです。APIの単価はGPT-6 SolがOpus 5.5の半分で、公表された評価では、長く大きな仕事の完成度でOpus 5.5が上回る結果が目立ちます。
この記事では、2026年9月23日に両社の公式発表・料金ページ・ヘルプを確認し、料金、使える場所、得意な仕事の順に比べます。性能の数値は各社が公開した評価で、PROBEFOLIOが同じ条件で試した結果ではありません。
両社は選ぶテストや設定が違うため、数字を並べるときは「同じテストか」「費用の計算方法が同じか」を確かめる必要があります。
この記事の目次
結論:量と費用ならGPT-6 Sol、一回の仕事の完成度ならOpus 5.5
2つのモデルは、どちらも「難しい仕事を、最上位モデルより安く任せる」ことを目指しています。違いは、どこに重心を置いているかです。
GPT-6 Solは、OpenAIの最上位モデルGPT-6 Astraの技術を、より安く速いモデルに持ち込んだものです。APIの単価が前の世代の半分になり、大量の作業を回しやすくなりました。
Opus 5.5は、多くの仕事で上位モデルFable 5.1と同じ水準の性能を、Opus 5より約40%安い費用で出すモデルです。長いコード移行や、根拠を確かめながら書く資料づくりで強い結果が報告されています。
2つのモデルの選び方
- GPT-6 Solを選ぶ場面
同じ種類の作業を大量に回す、費用を抑えたい、ChatGPT WorkやCodexで使う
- Claude Opus 5.5を選ぶ場面
大きなコード修正・移行、根拠つきの資料づくり、グラフや画面の読み取り、Claude Codeで使う
迷ったら、同じ仕事を両方に頼み、仕上がりと費用を比べるのが確実です。手順はこの記事の最後の節で紹介します。
基本情報の比較:料金・読める量・知識の期限・使える場所
読める量(コンテキスト)は、GPT-6 Solが105万トークン、Opus 5.5が100万トークンで、ほぼ同じです。1回の最大出力はどちらも12万8,000トークンです。
知識の期限は、GPT-6 Solが2026年4月20日、Opus 5.5が2026年6月です。それ以降の出来事は、Web検索などのツールを使わない限り知りません。
考える量の設定は、どちらもlowからmaxまでの段階があります。GPT-6 Solは考えない「none」も選べます。Opus 5.5は考える機能を切れず、既定はmediumです。
| 項目 | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|
| API料金(100万トークン) | 入力4ドル・出力20ドル | 入力2ドル・出力10ドル |
| キャッシュの読み込み | 0.20ドル | 0.20ドル |
| 長い入力の割増 | なし(100万トークンまで標準) | 27万2,000トークン超で入力2倍・出力1.5倍 |
| 読める量 | 100万トークン | 105万トークン |
| 知識の期限 | 2026年6月 | 2026年4月20日 |
| 考える量の設定 | low〜max(既定medium) | none〜max(既定medium) |
| チャットで使う | Claudeアプリ(Pro以上) | ChatGPTのChatでは不可。WorkとCodex |
| 開発ツール | Claude Code(2.1.280以上) | Codex(アプリ・CLI・IDE拡張) |
料金の比較:単価はSolが半分。長い入力とキャッシュでは差が縮む
単価だけを見ると、GPT-6 SolはOpus 5.5の半分です。ただし、実際の費用は使い方で変わります。3つの使い方で計算しました(2026年9月23日の定価、標準処理)。
例1:Q&Aを1,000回(1回あたり入力2,000・出力800トークン)では、単価どおりGPT-6 Solが半分です。
例2:50万トークンの資料を1回で読ませると、GPT-6 Solは27万2,000トークンを超えたためリクエスト全体に割増がかかり、Opus 5.5とほぼ同じ費用になります。Opus 5.5は100万トークンまで割増がありません。
例3:10万トークンの資料をキャッシュして30回やり取りすると、キャッシュの読み込みが両方とも0.20ドルのため、差は約1.7倍に縮みます。
| 使い方 | Opus 5.5 | GPT-6 Sol |
|---|---|---|
| 例1:Q&Aを1,000回 | 24.00 | 12.00 |
| 例2:50万トークンの資料を1回(出力5,000) | 2.10 | 2.075 |
| 例3:資料10万をキャッシュして30回 | 2.88 | 1.73 |
| 参考:入力100万・出力10万トークン | 6.00 | 3.00 |
同じテストで比べられる数字:AutomationBench
両社の発表に共通して登場するのが、Zapierの「AutomationBench」です。営業・経理・人事など47の業務アプリをまたいで、仕事の流れを最後までこなせるかを見るテストです。両社とも公開ランキングのリリース1.0.6を参照しています。
成績はOpus 5.5(max)が40.0%、GPT-6 Sol(xhigh)が33.2%で、Opus 5.5が上です。最上位はGPT-6 Astraの41.4%でした。
一方、費用はGPT-6 Solが1タスク約0.27ドル(OpenAI発表)です。Opus 5.5はAnthropicの図では最高設定で約1.4ドル(図からの読み取り)で、Solの約5倍になります。成績と費用のどちらを重視するかで、選ぶモデルが変わります。
ただし、費用の数字は計算方法で大きく変わります。同じClaude Opus 5(max)の1タスクの費用が、Anthropicの図では約1.3ドル、OpenAIの発表ではGPT-6 Solの11.1倍(約3ドル)と、2倍以上違います。キャッシュを計算に入れるかどうかなどの違いと考えられます。費用は「同じ会社の図の中での比較」として読むのが安全です。
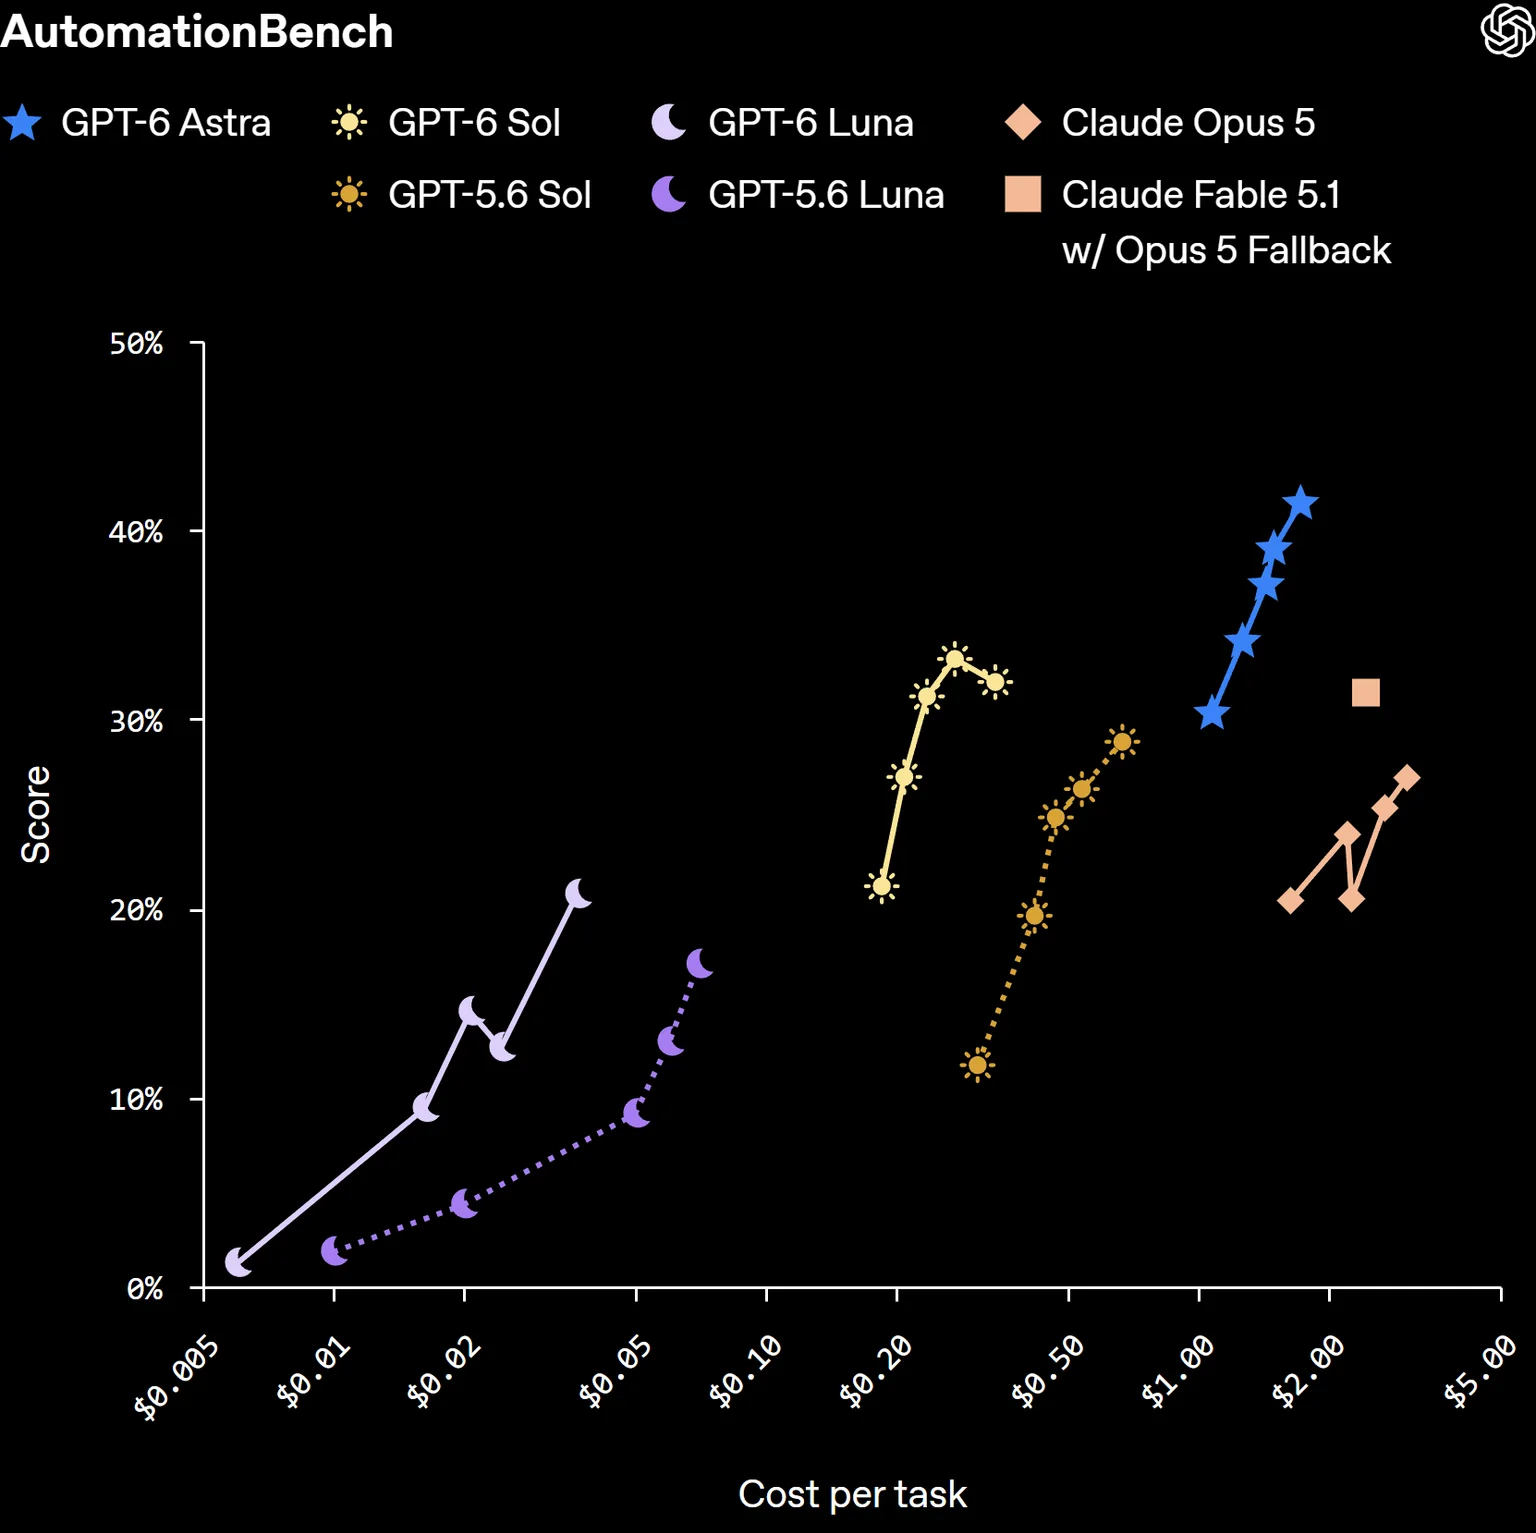
| モデル(設定) | 成績 | 出典 |
|---|---|---|
| GPT-6 Astra(max) | 41.4% | Anthropic発表の表 |
| Claude Opus 5.5(max) | 40.0% | Anthropic発表(Zapierの評価) |
| GPT-6 Sol(xhigh) | 33.2% | OpenAI発表 |
| Claude Fable 5.1(max) | 31.4% | 両社の発表 |
| GPT-6 Astra(low) | 30.3% | OpenAI発表 |
| Claude Opus 5(max) | 26.9% | 両社の発表 |
コーディング:両社とも「少ない費用で上位」と発表
コーディングのテストは、両社で選んでいるものが違い、同じ条件で並べられる数字は多くありません。
採用される修正を書けるかを見るFrontierCodeでは、Opus 5.5がmedium設定の54.6%で、評価されたモデルの中で最高と報告されています。OpenAIは、GPT-6 SolがGPT-5.6 Solから大きく伸び、Claude Fable 5.1のxhighと同じ水準を、ずっと低い費用で出したとしています。
長く複雑な開発を見るDeepSWEでは、GPT-6 Sol(max)が68.8%で、Claude Fable 5の最高点(69.9%)まで1.1ポイントの差を約80%低い費用で出しました。Opus 5.5のDeepSWEの成績は発表されていません。
実際の開発作業に近いCursorBench 4.0では、Opus 5.5がmaxで57.8%と公開ランキングの1位でした。GPT-6 Solの成績は、確認時点でAnthropicの資料に載っていません。
コーディング目的なら、使う道具(Claude CodeかCodexか)も選択に関わります。道具の違いはCodexとClaude Codeを比較で解説しています。
仕事別:どちらから試すか
公式発表の内容から、仕事の種類ごとにどちらを先に試すとよいかを整理しました。どちらか一方で済むとは限らないので、最初に試すモデルの目安として使ってください。
| 仕事 | 先に試す | 理由 |
|---|---|---|
| 大規模なコードの移行・監査 | Opus 5.5 | 20万行の監査を3時間未満で終えた報告など |
| 根拠を確かめながら書くレポート | Opus 5.5 | 数字や引用をでっち上げない基準で18本中16本合格 |
| グラフ・画面からの数値の読み取り | Opus 5.5 | ツールなしのChartographyでOpus 5の2倍以上 |
| 業務アプリをまたぐ自動化 | 成績はOpus 5.5、費用はSol | AutomationBenchで40.0%と33.2%。費用はSolが低い |
| 同じ作業を大量に回す(要約・抽出など) | GPT-6 Sol(さらに安くするならLuna) | 単価が半分。Lunaはさらに20分の1 |
| 事実の確認が多い調べもの | GPT-6 Sol | 事実の誤りが前の世代の約半分(OpenAI社内評価) |
使える場所:Claudeアプリ・Claude Codeと、ChatGPT Work・Codex
Opus 5.5は、Claudeのアプリ(Pro・Max・Team・Enterprise)でふだんの会話から使えます。Claude Codeでも、2.1.280以上なら既定のモデルです。
GPT-6 Solは、ChatGPTのふだんの会話(Chat)では選べません。2026年9月23日にChatGPT Web版で確認すると、Chatのモデル一覧は「最新」「GPT-5.6 Sol」「GPT-5.5」で、GPT-6 Solは「Work」に切り替えたときのモデル一覧にありました。使い方はGPT-6 Solが表示されない・使えない?で解説しています。
| 使う場所 | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|
| ふだんのチャット | Claudeアプリ(Pro 月20ドルから) | 不可(ChatGPTのChatでは選べない) |
| 作業を任せるモード | Claudeアプリ・Claude Code | ChatGPT Work(Plus以上) |
| 開発ツール | Claude Code | Codex(アプリ・CLI・IDE拡張) |
| 無料プラン | 不可 | 不可(無料・Goはデスクトップアプリで下位のLunaのみ) |
| API | claude-opus-5-5 | gpt-6-sol |
同じ課題で2つを試す手順
発表された数字だけで決めきれないときは、自分の仕事で比べるのが確実です。同じ入力・同じ条件で頼み、仕上がり・かかった時間・手直しの量を記録します。
この節の最後にある依頼文は、比べるときの条件をそろえるためのものです。両方に同じ文章を渡してください。
- 比べる仕事を1つ決め、同じ資料・同じ依頼文を両方に渡す
- 考える量はどちらも標準(medium)からそろえる
- 仕上がりを、事実の正しさ・抜け漏れ・手直しの量で比べる
- APIなら使ったトークン数と費用を、月額プランなら利用上限の減り方を記録する
- 1回だけで決めず、同じ依頼を2〜3回試してばらつきを見る
よくある疑問を、ここで。
使い始める前に、気になるところから。
Claude Opus 5.5とGPT-6 Sol、結局どちらが賢いですか?
共通のテストが少なく、一言では決められません。両社が参照するAutomationBenchではOpus 5.5が40.0%、GPT-6 Solが33.2%でした。費用はGPT-6 Solのほうが低く、仕事の種類と予算で選び分けるのが現実的です。
API料金はどちらが安いですか?
単価はGPT-6 Sol(入力2ドル・出力10ドル)がOpus 5.5(入力4ドル・出力20ドル)の半分です。ただし、27万2,000トークンを超える入力ではGPT-6 Solに割増がかかり、キャッシュの読み込みは両方とも0.20ドルです。
ChatGPTの有料プランでGPT-6 Solを選べないのはなぜですか?
GPT-6 Solは、ChatGPTのWorkとCodex向けのモデルで、ふだんのChatでは提供されていません(2026年9月23日確認)。Workに切り替えるとモデル一覧に表示されます。
両方契約する必要はありますか?
多くの人は、普段使っているサービス(ChatGPTかClaude)で使えるモデルから試せば十分です。仕事で費用や仕上がりの差が大きい作業だけ、APIや追加の契約でもう一方を試すと無駄が少なくなります。
この記事を共有する
商品情報の提供:Supported by Rakuten Developers
出典と、この記事について
公式資料や、記事で参照した発表・報道をまとめています。仕様や料金は、利用する前に最新の案内をご確認ください。
- Anthropic:Introducing Claude Opus 5.5(2026年9月22日)(新しいタブで開きます)
- OpenAI:Introducing GPT-6 Sol and Luna(2026年9月22日)(新しいタブで開きます)
- Anthropic:System Card: Claude Opus 5.5(PDF)(新しいタブで開きます)
- Claude Platform Docs:Claude Opus 5.5(新しいタブで開きます)
- OpenAI API:GPT-6 Sol(新しいタブで開きます)
- Claude Platform Docs:Pricing(新しいタブで開きます)
- OpenAI API:Pricing(新しいタブで開きます)
- OpenAI Help Center:ChatGPT Work and Codex(新しいタブで開きます)
- Anthropic:Claude Opus(新しいタブで開きます)
- Claude:Plans & Pricing(新しいタブで開きます)
- Claude Platform Docs:Prompting Claude Opus 5.5(新しいタブで開きます)
- 画面の出典:ChatGPT Web版(2026年9月23日に確認)(新しいタブで開きます)
確認した内容と条件は本文に記載しています。結果や使い勝手は、資料や環境によって異なります。編集方針を読む
ぜひコメントください