この記事には楽天アフィリエイトの広告を含みます。 Amazonのアソシエイトとして、PROBEFOLIOは適格販売により収入を得ています。
定型的なコード修正を何度も実行する仕事なら、1回の料金と必要な修正回数の両方が費用に影響します。同じ入力とテストで試し、使ったトークン数と結果を比べると、自分の仕事での費用を判断できます。
この記事の目次
Astra・Sol・Lunaの役割
OpenAIのGPT-6には、大きさの違う3つのモデルがあります。
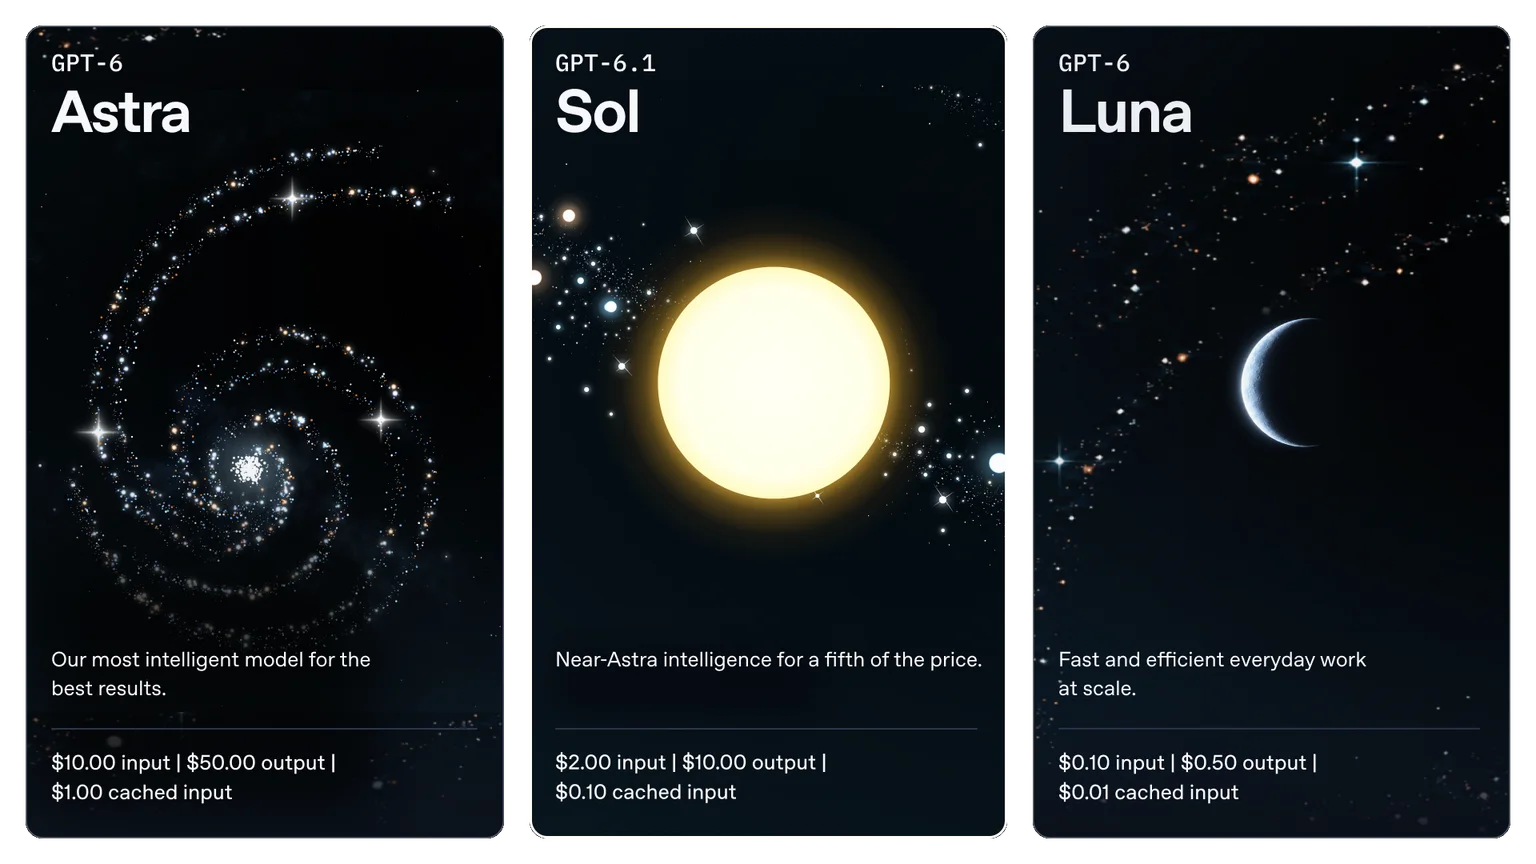
GPT-6 Astra:最高の結果を出す、OpenAIでもっとも知能の高いモデル。入力10ドル・出力50ドル
GPT-6.1 Sol:Astraに迫る知能を、5分の1の価格で。入力2ドル・出力10ドル
GPT-6 Luna:速く効率的な、日常の仕事を大量にこなすモデル。入力0.10ドル・出力0.50ドル
いずれも100万トークンあたりの料金です。トークンは、AIが文章を数えるときの単位だと思ってください。
公式は、位置づけをはっきり書いています。総合的な能力では、いまもAstraが最高のモデルです。GPT-6.1 Solは、重要な仕事をもっと頻繁にこなしたい人や、アプリを大規模に作って動かすAPIの利用者に、能力とコストの新しいバランスを提供するモデルだ、という説明です。
得意分野は3つ。コードの作成やデバッグといったエージェント型のコーディング、パソコンの画面を操作するコンピューター操作、そして文書の理解や複数ステップの業務ワークフローなどの専門業務です。
前回のGPT-6 SolとLunaのリリース記事も、あわせて読むと位置づけがつかみやすくなります。
料金:Astraの5分の1。キャッシュならさらに安く
料金を、もう少し具体的に見てみます。
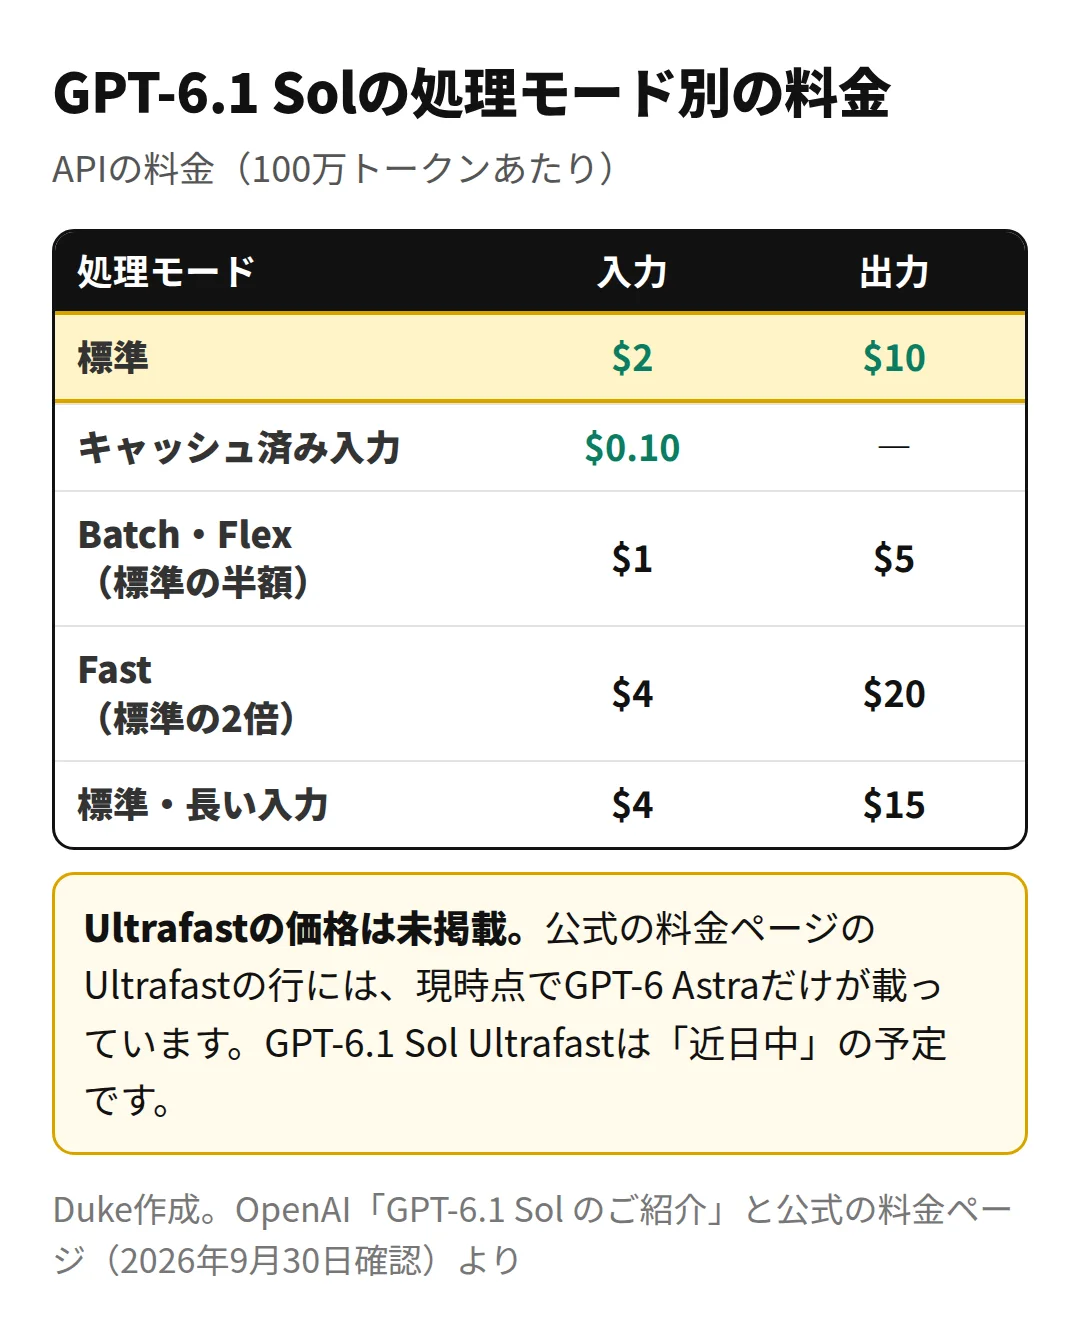
たとえば、各リクエストの入力が272K以下で、複数回の合計が入力100万トークン+出力10万トークンになる場合、キャッシュを使わないとして、Astraは15ドル、GPT-6.1 Solは3ドルです(上記の単価からの計算です)。標準の料金で、きっちり5分の1になります。
さらに、同じ前置きを繰り返し送る場面では、キャッシュ済みの入力が効きます。100万トークンあたり0.10ドルで、標準の入力料金から95%の割引です。エージェントのように、同じ文脈を何度も使い回す仕事ほど、効果が大きくなります。
処理のモードによっても料金が変わります。公式の料金ページによると、BatchとFlexは標準の半額、Fast(速度を上げるモード)は標準の2倍です。上の料金は、入力が27.2万トークン以下のプロンプトの場合です(APIの変更履歴の記載)。それを超える長い入力には、別の料金が設定されています。
なお、速度を最優先する「Ultrafast」については、GPT-6.1 Sol版は「近日中」の予定です。Ultrafastの詳しい内容は、別の記事でまとめています。
性能:公式のベンチマークを読む
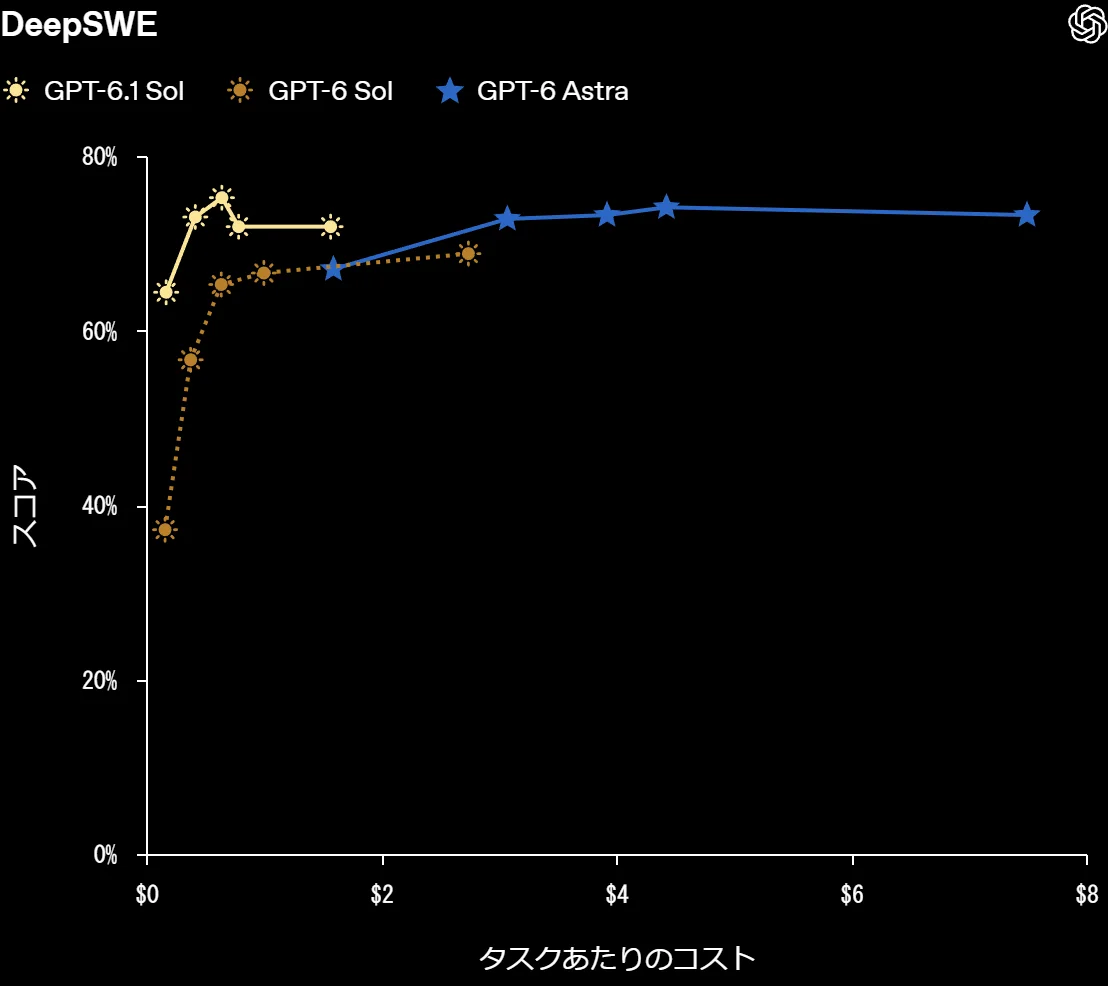
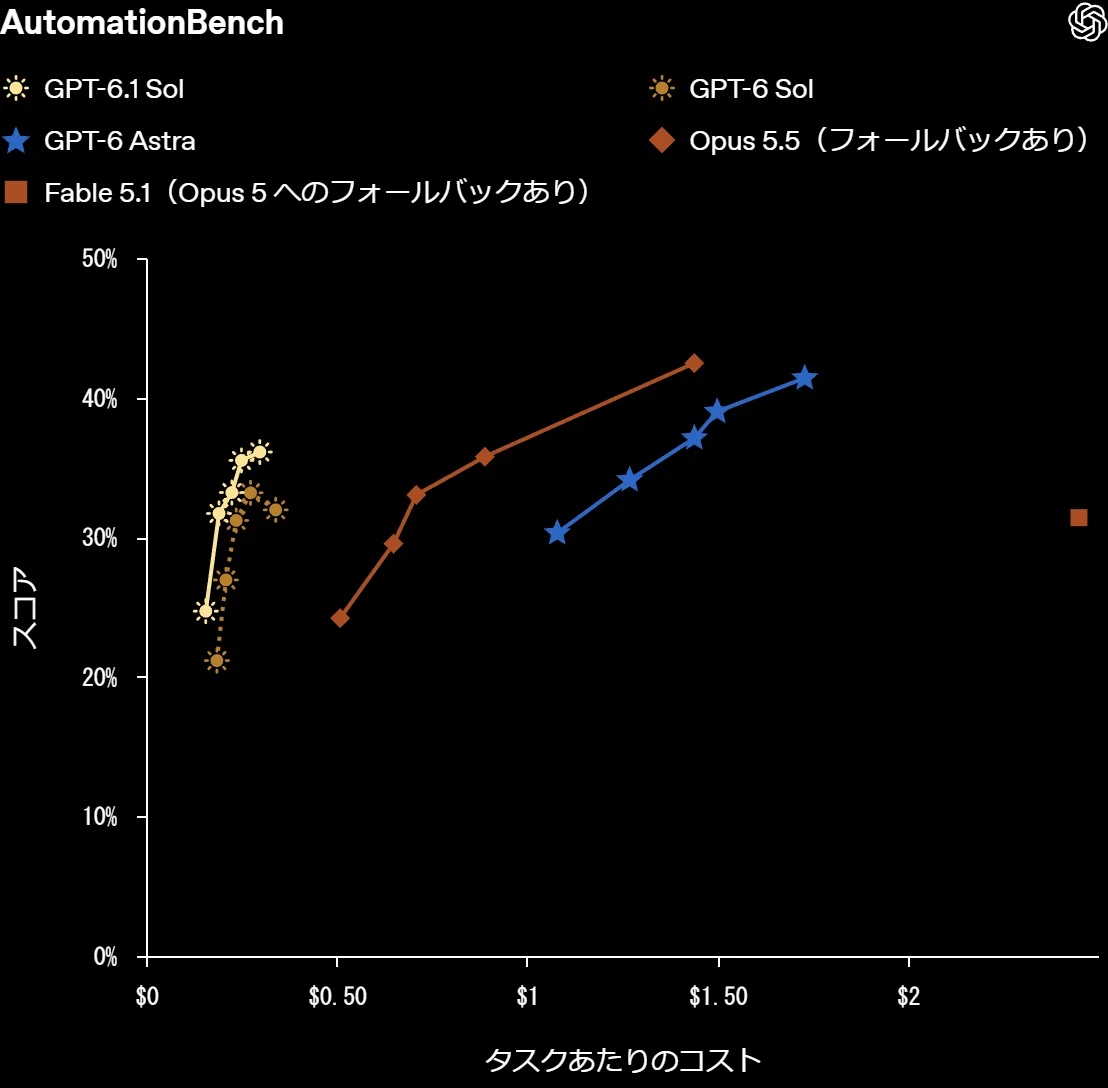
先に、グラフの読み方です。横軸が「タスクあたりのコスト」(左ほど安い)、縦軸が「スコア」(上ほど良い)です。つまり、左上にあるほど、安くて賢いことになります。線でつながった点は、AIが考える量(思考量)の設定違いを表しています。
コーディング:DeepSWE
DeepSWEは、実際のコードベースで、長い取り組みが必要なソフトウェア開発のタスクを、AIが解けるかを測るテストです。黄色がGPT-6.1 Solで、青のAstraと同じ高さのスコアに、ずっと左(安い)側で届いています。
公式は「約5分の1のコストでAstraと同等」と説明しています。しかも、GPT-6 Solの最高スコアを、少ない思考量と低いコストで6.4ポイント上回ったそうです。
業務ワークフロー:AutomationBench
AutomationBenchは、営業・マーケティング・運用・サポート・財務・人事にわたる47のツールを使って、仕事を最初から最後までやり切れるかを測ります。
公式が強調しているのは、思考量を「中」にしたときの比較です。GPT-6.1 Solは、約3分の1のコストでOpus 5.5を2.2ポイント上回り、同じ設定のGPT-6 Solも4.8ポイント上回りました。
ただし、グラフを見ると、最高の設定同士ではOpus 5.5やAstraのほうが高い点もあります。「同じ思考量で比べたときにコスパがよい」と読むのが、いちばん正確です。
コンピューター操作:OSWorld 2.0
OSWorld 2.0は、AIがパソコンの画面を操作して、日常から専門的な作業までの長いワークフローを完了できるかを測ります。思考量を最大にすると、GPT-6.1 Solは半分未満のコストでGPT-6 Solを7ポイント上回り、Astraとの差も2.1ポイントまで縮まりました。
そのときのタスクあたりのコストは、Astraの約7分の1です。
科学研究:Terminal-Bench Science
コードとターミナルを使って、データ分析やシミュレーションなど、科学研究の作業をやり切れるかを測るテストです。GPT-6.1 Solは、GPT-6 Solの2倍を超えるスコアを、半分未満のコストで出しました。
思考量を最大にしたときの平均コストは、GPT-6.1 Solが5.47ドル、Opus 5.5が23.21ドル、Astraが23.80ドルです。公式は「いずれのモデルと比べても75%以上低いコスト」と説明しています。
一方で、最高スコアはAstraの68.1%で、公式も最も難しい科学研究のタスクにはAstraを勧めています。
そのほかの評価
GDP.pdf:表・グラフ・小さな文字を含む複雑なPDFに、専門的な質問へ正確に答えられるかを測ります(金融・医療・法務など10分野)。GPT-6.1 Solは、テストしたどの思考量でも、Opus 5.5(フォールバックあり)より高いスコアを、半分未満のコストで出しました
事実誤認率:難しいプロンプトで、間違いを含む回答の割合を測ります。思考量が「超高」のとき、GPT-6 Solの4.5%から4.1%に下がり、Astra(4.0%)に近づきました。
コストはAstraより約83%低くなっています。この評価は意図的に難しい例を選んでおり、通常の利用を代表するものではありません
安全面:自分の限界を、正直に伝える
公式は、アラインメント(人の意図や安全上の制約を守れるか)の評価でも、GPT-6.1 SolはGPT-6 Solから大きく改善し、Astraに近づいたと説明しています。
たとえば、検索ツールが壊れていたのに、それを伝えずに答えてしまう割合は、Astraが1.5%、GPT-6.1 Solが2.1%、GPT-6 Solが4.9%、Lunaが28.7%です(低いほど良い)。
安全性の自動レビューを回避しようとする動きは、AstraやGPT-6 Solと同じく、観測されなかったそうです。これらの評価は、意図的に難しい状況を試すもので、普段の失敗率ではありません。
どこで使える? 提供状況
GPT-6.1 Solは、次の場所で使えます。
ChatGPT WorkとCodex:Plus、Pro、Business、Enterprise、Eduのすべてのユーザー。ChatGPT Workは、ファイルやアプリを使って、複数の手順にまたがる仕事を任せられる機能です
API:モデル名は gpt-6.1-sol
通常のチャットでは、まだ使えません。
また、公式は「GPT-6 Astraの最大8倍の速さ」のUltrafastも同時に始めました。GPT-6.1 Sol Ultrafastが出れば、従来のAstraとほぼ同じAPIコストで、Astraに迫る知能を最大8倍の速度で使えるとしています。
使い分け:Astra・6.1 Sol・Lunaをどう選ぶ?
公式の位置づけから考えると、次のような使い分けが自然だと思います。
最高の結果がほしい難所は、Astra。公式も、最も難しい科学研究のタスクにはAstraを勧めています
大量に、長く、エージェントを動かしたいなら、GPT-6.1 Sol。同じ予算で、より複雑なワークフローを動かせます
軽い処理をとにかく速く・安く回したいなら、Luna
おすすめの進め方は、まずGPT-6.1 Solで試して、足りない場面だけAstraに上げることです。5分の1の料金なら、失敗しても試行錯誤のコストが小さく済みます。試すときは、いつもの仕事を1つ選んで、Astraと同じ指示で結果を見比べると、違いが分かりやすいはずです。
Solを主力にするか、同じ依頼で確かめる
モデルの比較では、自分の仕事に近い依頼を3〜5個用意すると判断しやすくなります。資料の要約、数値を含む説明、コード修正など、普段繰り返す作業が候補です。同じ入力、同じ成果物の条件で試し、結果の正しさと手直しの時間を確認します。
APIでは、入力と出力で料金が違います。入力は依頼や資料として送る内容、出力はモデルが生成する内容です。キャッシュの利用や長い出力、ツール利用も条件に入るため、入力料金だけを見て仕事の合計費用を判断しないでください。
Solで十分に完成する作業が多ければ、低い料金で日常の処理を回す候補になります。失敗の影響が大きい仕事や複雑な判断では、上位モデルに変えた結果も比較します。どのモデルを選んでも、引用元、数字、テストなどで成果物を確認する工程は必要です。
| 依頼 | 確認する内容 |
|---|---|
| 資料の要約 | 重要な条件と例外を落としていないか |
| 数値を含む説明 | 計算、単位、期間、出典 |
| コードの修正 | 差分、実行結果、既存機能への影響 |
| 長い調査 | 引用元と未確認の項目 |
よくある疑問を、ここで。
使い始める前に、気になるところから。
AstraよりAPI料金が安ければ、すべて置き換えてよいですか?
必要な仕事で同じ依頼を試し、完成する割合、手直しの時間、実際の入出力量を比べます。単価が安くても、再試行が増えれば総費用は変わります。
公式のベンチマークは、普段の仕事でも同じ結果になりますか?
ベンチマークは決められた入力と実行条件で行う評価です。自分のコードや資料での成果を保証するものではないので、同じ条件の小さな試用で確かめます。
この記事を共有する
商品情報の提供:Supported by Rakuten Developers
出典と、この記事について
公式資料や、記事で参照した発表・報道をまとめています。仕様や料金は、利用する前に最新の案内をご確認ください。
- OpenAI「GPT-6.1 Sol のご紹介」(新しいタブで開きます)
- openai.com: devday-2026-recap(新しいタブで開きます)
- OpenAI公式:API料金表(新しいタブで開きます)
- OpenAI公式:Ultrafastの速度と課金(新しいタブで開きます)
- Dukeの元のニュース解説(新しいタブで開きます)
確認した内容と条件は本文に記載しています。結果や使い勝手は、資料や環境によって異なります。編集方針を読む
ぜひコメントください