この記事には楽天アフィリエイトの広告を含みます。 Amazonのアソシエイトとして、PROBEFOLIOは適格販売により収入を得ています。
GPT-6 AstraとClaude Opus 5.5は、複雑な調査や開発を扱う上位AIモデルです。例えば「この不具合を直し、テストまで終えて」と頼む仕事では、最初の返事の速さより、修正が正しく終わるかと総費用が重要になります。
公式の比較表ではOpus 5.5が上回る項目も、Astraが上回る項目もあります。この記事は公式資料の比較です。PROBEFOLIOが両モデルを同条件で実測した結果ではありません。
この記事の目次
モデルと、仕事に使う道具を分けて考える
モデルは、文章や資料を読み、次の回答や操作を考えるAI本体です。Claude CodeやCodexは、AIがファイルを読んだり、コードを変更したり、テストを実行したりするための開発環境です。同じモデルの評価でも、使える道具や指示で結果は変わります。
ChatGPTとClaudeのアプリで使う場合も、選べるモデル、接続できるサービス、使える量をプランごとに確認します。すでに使っているリポジトリや資料の保存先へ接続できるかは、日々の作業で無視できない違いです。
開発の評価では、何を完了できたかを見る
Terminal-Bench 4.0は、コマンド操作を含む複数段階の仕事を完了できるか測るテストです。Anthropicの発表表ではOpus 5.5が66.4%、Astraが57.9%。FrontierCodeは開発の変更の品質を評価し、54.4%と53.3%です。
この表はAnthropicが掲載した評価で、Astraの多くの数字はOpenAIの報告値です。Terminal-Benchの推論設定はOpusがxhigh、Astraがhigh。ハーネスという実行環境、道具、安全対策も関係します。差をそのまま、自分の開発で成功する確率とは読めません。
| 開発のテスト | Opus 5.5 | GPT-6 Astra |
|---|---|---|
| Terminal-Bench 4.0(複数段階の操作) | 66.4% | 57.9% |
| FrontierCode v1.1 Main(コード変更) | 54.4% | 53.3% |
科学研究や業務自動化ではAstraが上回る項目もある
同じ表のAutomationBenchは、複数のアプリにまたがる業務を評価します。Opus 5.5が40.0%、Astraが41.4%でした。科学研究に関するTerminal-Bench-Scienceでは58.7%と64.6%で、Astraが上です。
AutomationBenchはZapierの評価で、Opusの安全対策が介入した場合を失敗に数えるなど、条件があります。Humanity’s Last Examのような難問テストで強いことも、普段のメールや表計算で必ず優れるという意味にはなりません。自分の仕事に近い測定対象を選んで読みます。
| テスト | Opus 5.5 | GPT-6 Astra |
|---|---|---|
| AutomationBench(業務自動化) | 40.0% | 41.4% |
| Terminal-Bench-Science 0.1(科学研究) | 58.7% | 64.6% |
同じ文章量なら、標準API単価は2.5倍の差
APIは、アプリや開発環境からAIを呼び出し、使った量に応じて支払う利用方法です。単価は100万トークンあたりで表示されます。トークンは文字列を処理するときの単位で、日本語の文字数そのものとは一致しません。
入力10万トークン、出力1万トークンを1回処理する例を計算します。Opusは4×0.1+20×0.01で0.60ドル、Astraは10×0.1+50×0.01で1.50ドル。これはキャッシュ・高速設定・外部ツール料金を使わない標準単価の計算例です。
実際の総費用は、やり直しや考えるためのトークン、長文入力の条件でも変わります。Astraは入力が27万2,000トークンを超えるリクエストで料金倍率が変わります。短い例の計算を、そのまま大量の資料へ当てはめないでください。
| 料金の項目 | Opus 5.5 | GPT-6 Astra |
|---|---|---|
| 通常の入力 | 4ドル | 10ドル |
| 通常の出力 | 20ドル | 50ドル |
| 例:入力10万+出力1万 | 0.60ドル | 1.50ドル |
月額のプランは、API単価とは別に選ぶ
ChatGPTの月額とAPIの従量課金は別です。Claudeでも、月額プラン内の利用とAPIで使った量の請求を分けます。APIが2.5倍高いという表から、月額プランのメッセージ回数も必ず2.5倍違うとは言えません。
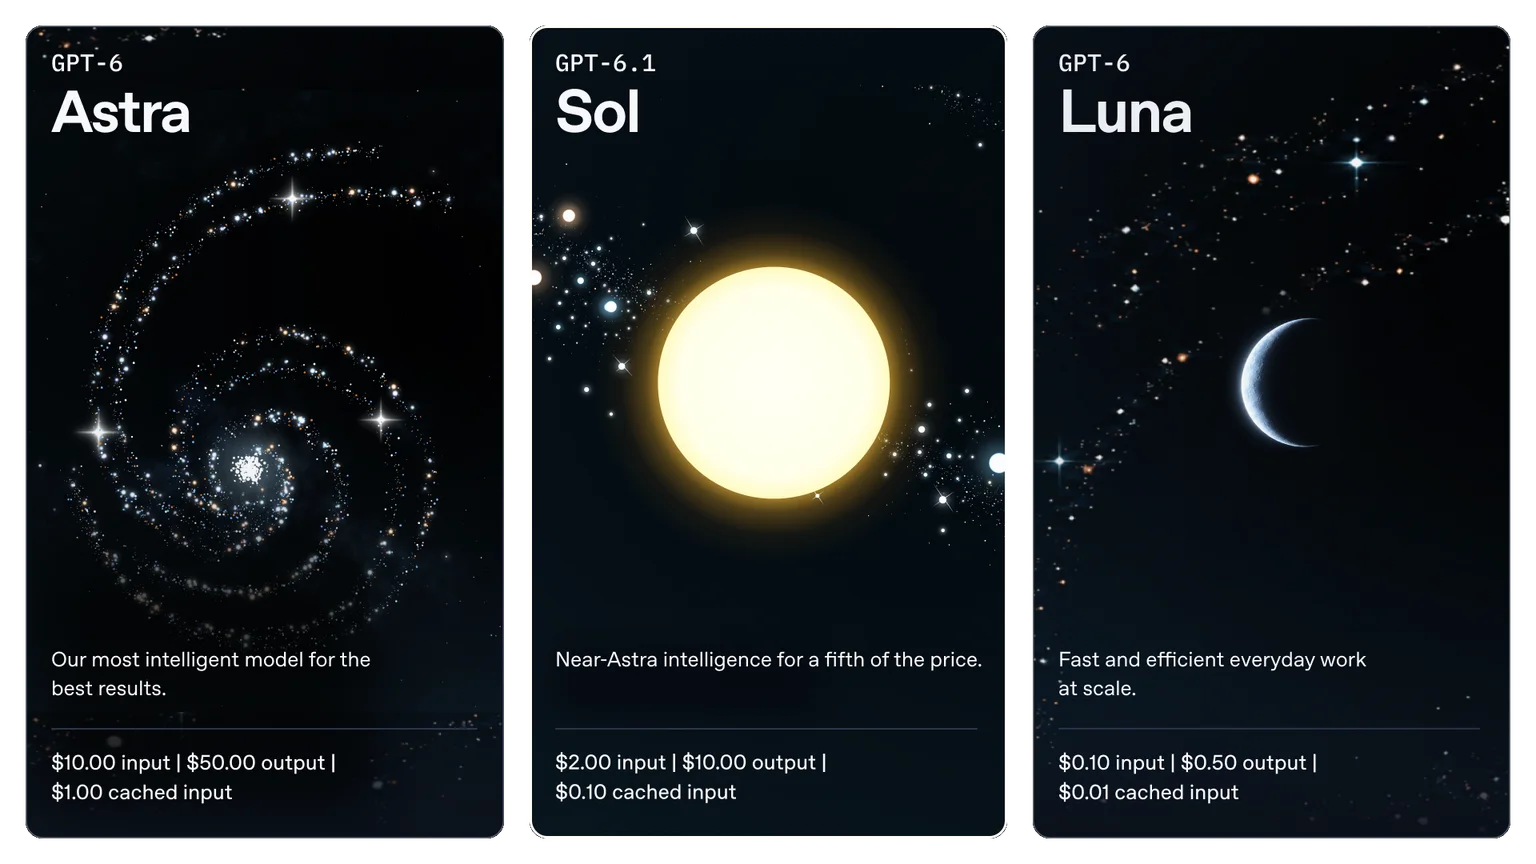
元記事は9月25日の状況を扱っていましたが、現在はPro $200の受付が再開され、Pro $500も案内されています。Sonnet 5.5とGPT-6.1 Solも発表済みです。上位2モデル以外の選択肢が増えた点を含め、現在の利用画面と公式料金で比べます。
繰り返す仕事を1つ選び、同じ条件で比べる
例えば、既存の申し込み画面の不具合を直す仕事を選びます。同じ元ファイル、同じ症状、同じテスト、同じ変更してよい範囲を渡します。完成するまでの時間と、誤った変更を戻した回数を記録すれば、普段の仕事に近い違いが見えます。
文章作成なら、同じ資料と文字数、読者、必要な出典をそろえます。どちらも同じ制限の下で使い、正しさを人が確認する時間まで含めます。これは読者が比較するための方法で、本稿で実行した試験結果ではありません。
仕事に合うモデルを選ぶ順番
- 入力をそろえる
同じ資料・指示・変更できる範囲を渡す。
- 完了を確かめる
指定したテストや、資料との照合に成功したか見る。
- 総負担を比べる
完成までの時間・やり直し・料金や利用枠を記録する。
Opusで完了でき、Astraでは追加修正が必要なら、その仕事ではOpusが合う材料になります。別の仕事の結果まで証明するものではありません。
開発の費用と、既存の作業環境から選び始める
コード変更を繰り返す仕事では、Opus 5.5の単価と完了率が候補になります。Astraが高い評価を示す科学研究の仕事や、すでにCodexへ整えた環境では、Astraを同じ仕事で残して比較する意味があります。
契約を選ぶ前に、Opus 5.5の全体像やGPT-6.1 Solの価格と性能も確認できます。
高いプランを複数契約する判断は、実際に不足する枠や必要な機能を見てから行えます。
よくある疑問を、ここで。
使い始める前に、気になるところから。
Opus 5.5は必ず総費用が60%安くなりますか?
標準の入力・出力単価はAstraの40%ですが、総費用は出力の長さ、再試行、キャッシュ、ツール利用で変わります。0.60ドルと1.50ドルは同じ量を処理した計算例です。
公式表で上なら、自分の仕事でも優れますか?
テストが測る能力と実際の仕事が一致するとは限りません。同じ資料・指示・完了条件で試し、人が確認する時間も含めて比較できます。
ChatGPT Pro $200は今も申し込めませんか?
10月2日に確認した公式ヘルプでは、新規申し込みが再開されています。古い元記事の受付停止中という案内を、現在の条件として使わないでください。
この記事を共有する
商品情報の提供:Supported by Rakuten Developers
出典と、この記事について
公式資料や、記事で参照した発表・報道をまとめています。仕様や料金は、利用する前に最新の案内をご確認ください。
- Opus 5.5の公式発表(新しいタブで開きます)
- GPT-6 AstraのAPIモデル仕様(新しいタブで開きます)
- 現在のChatGPT Proプラン(新しいタブで開きます)
- DevDayの公式振り返り(新しいタブで開きます)
- Sonnet 5.5の公式発表(新しいタブで開きます)
- Dukeの元の比較記事(新しいタブで開きます)
確認した内容と条件は本文に記載しています。結果や使い勝手は、資料や環境によって異なります。編集方針を読む
ぜひコメントください