この記事には楽天アフィリエイトの広告を含みます。 Amazonのアソシエイトとして、PROBEFOLIOは適格販売により収入を得ています。
顧客の契約書をAIで整理したい企業では、内容を保存するか、誰が読めるか、安全性の確認で何が記録されるかが導入条件になります。モデルの性能だけでなく、データの保管と確認の流れを理解するための記事です。
この記事の目次
なぜ必要? 「保存しない」と「見張る」のジレンマ
AIを提供する側は、悪用されていないかを確かめる安全審査をします。ふつうは、送られた内容を一定期間残して、あとから調べます。
ところが、法務・金融・医療など、機密性の高い内容を扱う企業は、「AIの提供元に内容を残してほしくない」と考えます。これが、ゼロデータ保持(ZDR)です。ここで、「残さない」と「見張る」が、ぶつかります。
OpenAIの答えが、Private Safety Processing(PSP)です。公式は、次の3つの原則で作ったと説明しています。
お客様が内容を管理する:保存先は、お客様が管理するストレージ
人による確認をしない:安全審査が、OpenAIの社員が内容を読む新しい道にならないようにする
安全のためだけに保存する:内容は、承認された安全目的にだけ使われ、モデルの学習にも、OpenAIの他の部署やパートナーへの提供にも使えない
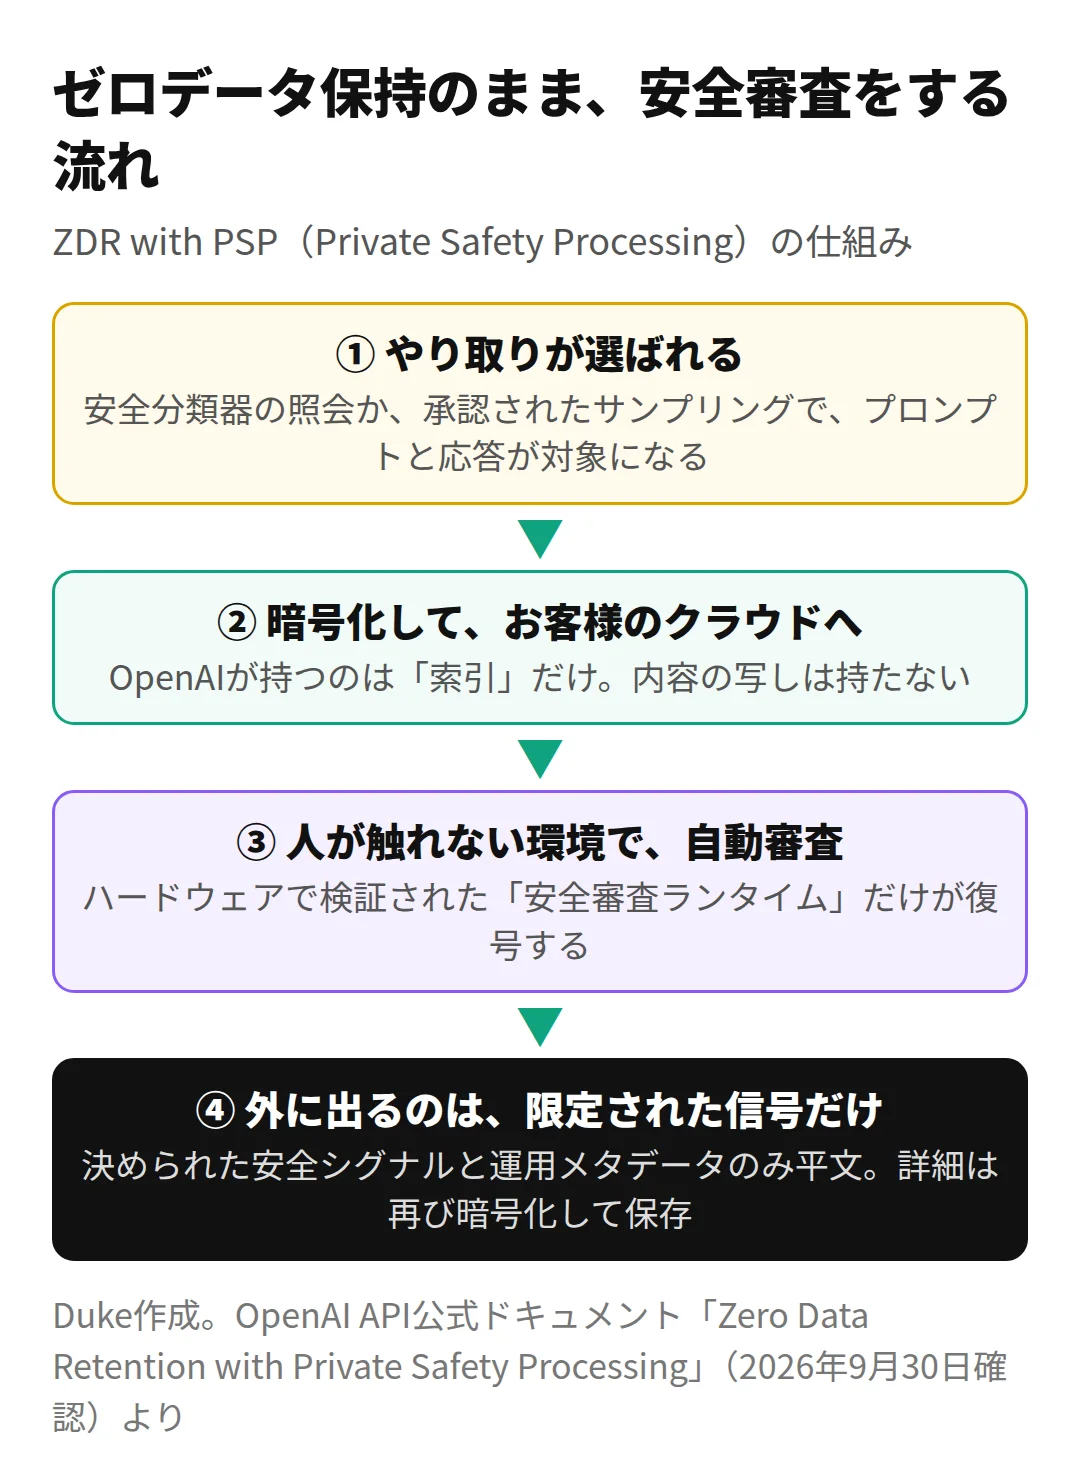
仕組みの流れ
流れは4つです。まず、やり取り(プロンプトと応答)のうち、安全分類器の照会か、承認されたサンプリングで選ばれたものだけが対象になります。照会されたからといって、違反が確定するわけではありません。
選ばれた記録は、暗号化して、お客様の地域のクラウドストレージに書き込まれます。OpenAIの側に残るのは、運用のための情報と、保存場所の参照を持つ「索引」だけです。内容の写しは持ちません。この暗号化と保存は、AIの応答を待たせずに、非同期で行われます。
審査を行うのは、安全審査ランタイムです。ハードウェアで「正しい環境か」を検証でき、人がアクセスできないようにした実行環境で、内容を復号できるのはここだけになるよう設計されています。そこで、承認された審査用の指示と、内容を出さない出力の形式に沿って、自動の審査を行います。
外に出るのは、あらかじめ決められた限定的な安全シグナルと、承認された運用メタデータだけ。詳しい結果は、再び暗号化して、お客様のクラウドに、元の記録と同じ期限で保存されます。
二重の鍵と、お客様の責任
保存した記録の内側には、OpenAIが管理する暗号化を使い、許可された安全審査ランタイムでだけ復号できるようにします。顧客管理の鍵を使うEnterprise Key Management(EKM)を有効にすると、さらに外側の暗号化が加わり、顧客側の鍵の承認も必要になります。
公式はEKMの有効化を勧めています。顧客側で承認を取り消すと、保持された記録を復号できなくなりますが、記録の削除や、すでに完了した処理の取り消しにはなりません。
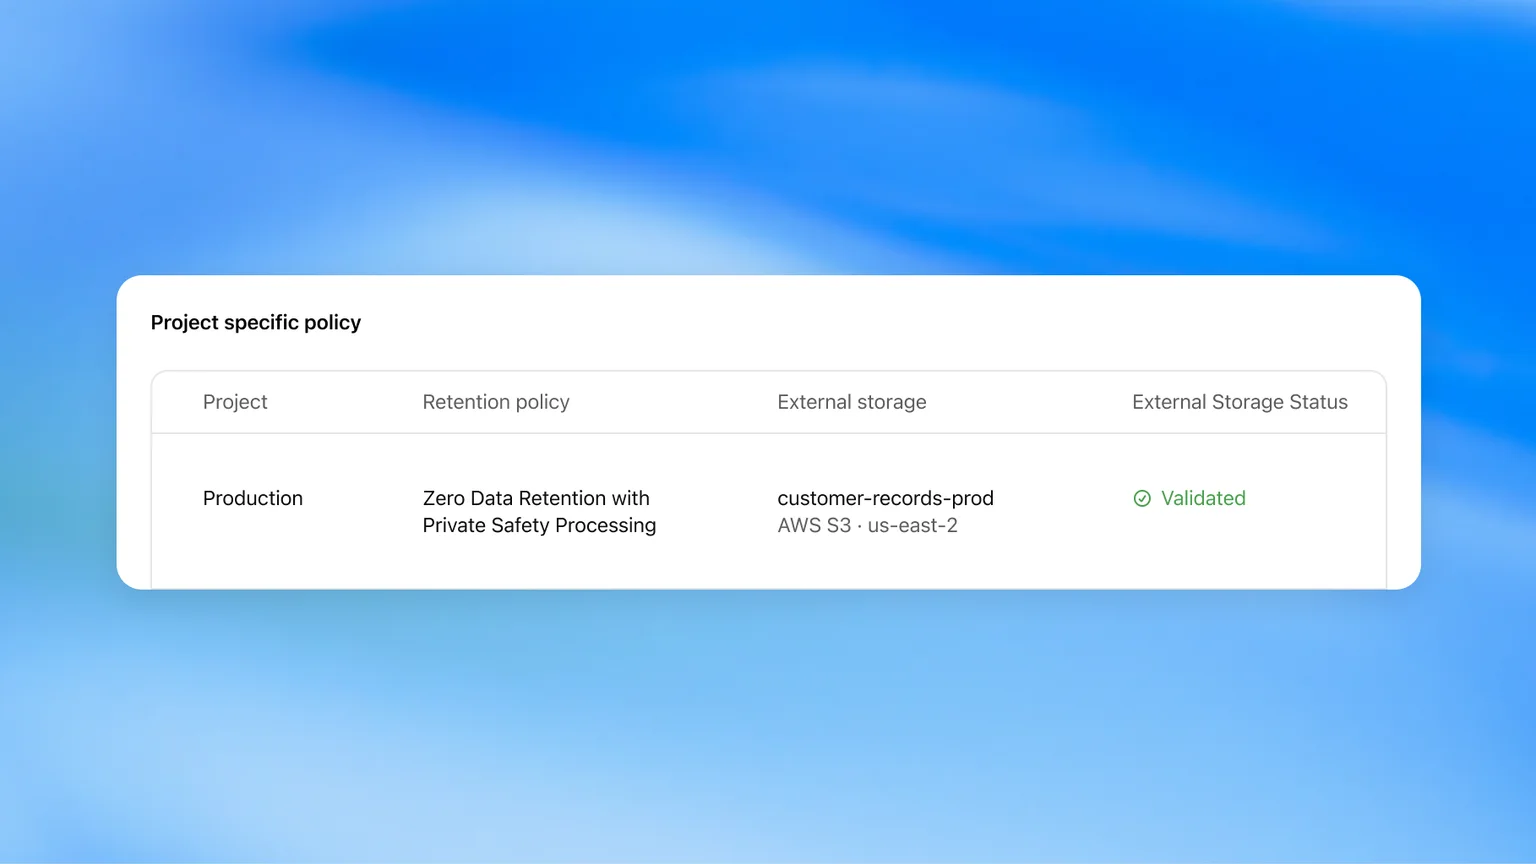
10月2日のガイドでは、安全性記録を顧客の地域の保存先へ30日間の期限付きで置くと説明しています。PSPはプロジェクト単位で有効にされ、そのプロジェクトのすべてのAPI通信に適用されます。PSPなしのZDRを使う対象リクエストは、別に設定したプロジェクトで扱います。
| 守る層 | 鍵と条件 |
|---|---|
| 内側 | OpenAIが管理する暗号化。許可された安全審査ランタイムで復号する |
| 外側(EKMを有効にした場合) | 顧客管理の鍵による追加の暗号化。顧客側の鍵の承認も必要 |
| 承認を取り消した場合 | 保持された記録を復号できなくなる。記録そのものの削除や、完了済みの処理の取り消しとは異なる |
Private Inferenceは?
もう1つの柱のPrivate Inferenceは、公式の振り返りでは、コンフィデンシャルコンピューティング(処理中のデータも保護される計算方式)と、厳格で検証できる管理を組み合わせて、最先端のモデルを使う顧客に強いプライバシーの保護を保証するもの、と説明されています。
現時点ではプレビュー版で、9月30日時点で、詳しい仕様の公式ドキュメントは確認できませんでした。
誰に関係する?
Private Intelligenceは、個人がすぐ試すものではなく、機密データを扱う企業のIT・セキュリティ担当に向けた仕組みです。自分の会社に関係するかは、次の3つで判断できそうです。
すでにゼロデータ保持を使っているか、必要としているか
自分のクラウド(AWS・Azure・GCP)で、暗号化ストレージと鍵を管理できるか
使いたいモデルが、PSPを必要とするか(公式ドキュメントには、PSPが必要なモデルがある、という書き方があります)
「AIに機密を入れていいのか」という社内の疑問に、技術の言葉で答えを出せるのが、この仕組みの価値だと思います。
「保存しない」がどこの保存を指すか確認する
企業の契約書をAIで整理する場合、送る内容がどこに保存され、誰が読めるのかを確認する必要があります。Zero Data Retentionは、OpenAIが顧客の入力と出力を保持しない条件を扱います。
一方、Private Safety Processingでは、安全性確認に使う暗号化した記録を顧客が管理する保存先に置く設計が説明されています。
そのため「一切どこにもデータが残らない」とだけ説明すると、顧客側の保存先や鍵の管理を見落とします。顧客は、記録を復号するための鍵、承認する安全性確認、保存先の管理、指定された運用上の条件を扱います。
導入前には、扱う情報の種類、保存先、保存期間、鍵を管理する担当、アクセスを認める手順を整理します。契約や対象モデルに条件があるため、個人のChatGPT設定を変更するだけで同じ仕組みになると解釈しないでください。
| 部分 | 確認すること |
|---|---|
| OpenAI側 | 入力・出力を保持する条件 |
| 顧客側の保存 | 暗号化した安全性記録の保存先と期間 |
| 鍵 | 誰が管理し、どの条件で復号を承認するか |
| 対象 | 対象契約、モデル、用途 |
| 運用 | 記録の確認と必要な対応を担う担当者 |
よくある疑問を、ここで。
使い始める前に、気になるところから。
ゼロデータ保持なら、どこにも記録が残りませんか?
OpenAI側の保持と、顧客側で管理する暗号化された記録を区別します。安全性の処理に使う記録の保存先と鍵、アクセスの条件を確認してください。
一般のAPI利用者は、自動的に対象ですか?
対象の企業契約・提供状況の確認が必要です。発表された仕組みが、すべてのAPIリクエストへ自動で適用されるとは判断しません。
この記事を共有する
商品情報の提供:Supported by Rakuten Developers
出典と、この記事について
公式資料や、記事で参照した発表・報道をまとめています。仕様や料金は、利用する前に最新の案内をご確認ください。
- OpenAI公式:ZDRとPrivate Safety Processing(新しいタブで開きます)
- OpenAI「DevDay 2026 の振り返り」(新しいタブで開きます)
- Dukeの元のニュース解説(新しいタブで開きます)
確認した内容と条件は本文に記載しています。結果や使い勝手は、資料や環境によって異なります。編集方針を読む
ぜひコメントください