この記事には楽天アフィリエイトの広告を含みます。 Amazonのアソシエイトとして、PROBEFOLIOは適格販売により収入を得ています。
同じ説明文でも、ゆっくり落ち着いて読む場合と、明るい案内のように読む場合では、聞き手の印象が変わります。読み上げる本文と、声や話し方の指定を分けることで、指示文自体を読んでしまう問題を避けられます。
この記事の目次
音声生成で増えた機能
TTS(Text-to-Speech)は、文章を音声に変える技術のことです。「テキスト読み上げ」や「音声合成」とも呼ばれます。
Googleは今回、2つのTTSモデルを同時に発表しました。
Gemini 3.8 Flash TTS:表現力を重視したモデル。オーディオブックやナレーション、キャラクターの声づくりなど、演技の細かさが大事な用途向け。130の言語に対応
Gemini 3.8 Flash-Lite TTS:速さと安さを重視したモデル。大量の吹き替えや、電話の自動応答(ボイスエージェント)など向け。101の言語に対応
どちらも日本語に対応しています。Googleの公式ブログは、今回の2モデルを次のように紹介しています。
「声の生成を、決まった声を選ぶだけのものから、自由に作り込めるクリエイティブなスタジオに変える」という意味です。この言葉どおり、中身は「読み上げ機能」というより、声の制作スタジオに近くなっています。
使える場所は、次のとおりです。
開発者向け:Google AI Studio(ブラウザで試せる画面)と、Gemini API(プログラムから呼び出す仕組み)
一般向け:Flash TTSは「Gemini Notebook」、Flash-Lite TTSは動画作成ツールの「Google Vids」に搭載
企業向け:Gemini EnterpriseのAPIで提供予定
できること①:声を「選ぶ」から「作る」へ
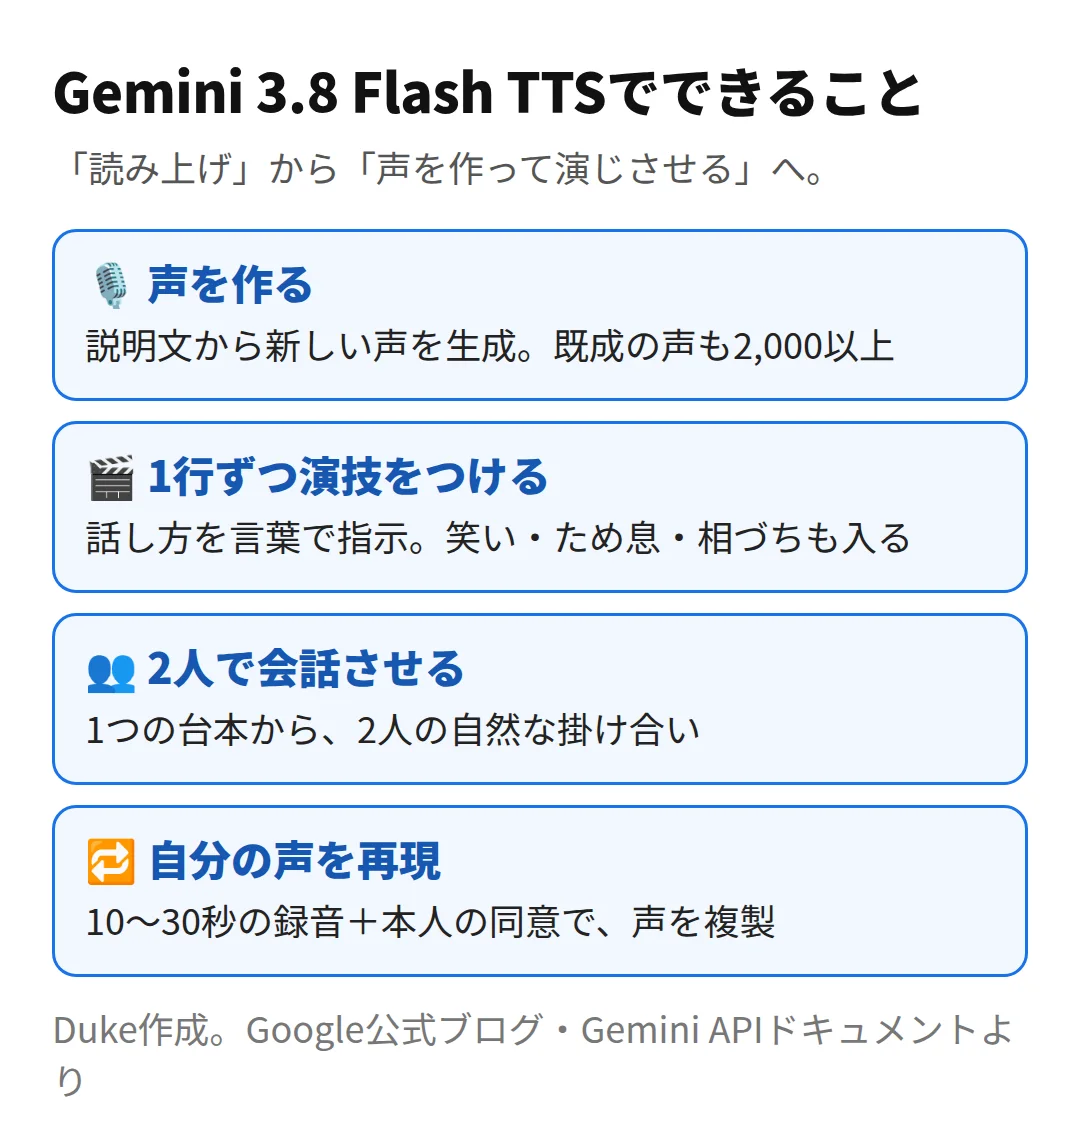
これまでのGeminiの読み上げでは、用意された30種類の声から選ぶのが基本でした。今回からは、声の選び方・作り方が一気に広がります。
説明文から声を作る「ボイスデザイン」では、役柄、なまり、声の特徴を指定します。例えば「ドキュメンタリーのナレーター。低く落ち着いた声で、静かにゆっくり語る」という入力です。100以上の言語・方言に対応すると説明されています。
2,000以上の既成の声も選べます。 地域のなまりを含む、すぐに使える声がそろっています。
作った声にはIDが付き、同じ声を次の生成でも指定できます。保存する方式では、プロジェクト当たり200件、保存期限1年という条件です。長く同じ説明音声を作るなら、声のIDと保存期限も管理します。
さらに、既成の声の高さや速さ、なまりを言葉で微調整する「ボイスリミックス」も、近日公開予定とされています。
読み上げる文章と、演技の指示を別に入れる
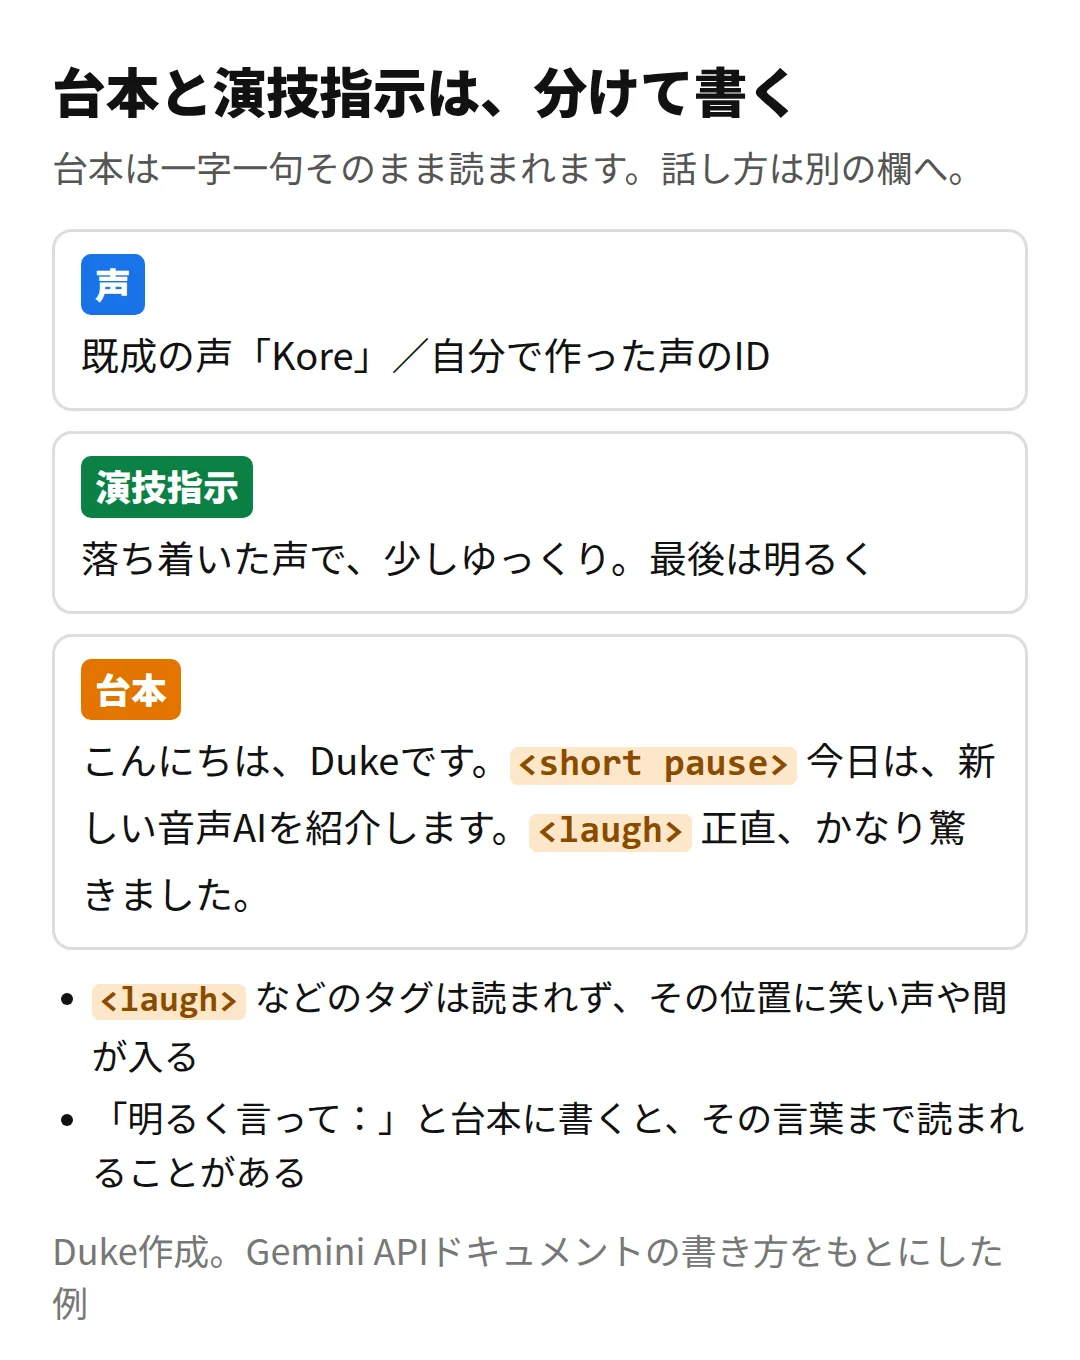
Gemini 3.8 Flash TTSでは、本文は読み上げる台本として扱います。本文の先頭に「落ち着いて読んで」と書くと、その言葉自体が読み上げられることがあります。APIでは各パートのspeech_metadata.styleへ、継続する話し方の指示を入れます。
たとえば本文を「次に、保存する場所を選びます。」、styleを「初めて操作する人へ、落ち着いた声で、少しゆっくり説明する」と分けます。笑い声や短い間のように、特定の位置で入れる演技は、本文中の対応タグを使います。
2人の会話では、各発話に指定する話者と、設定した話者名を一致させます。2026年9月30日更新のモデル案内では、通常の応答でWAVが返るため、以前のPCM向けのWAV変換をさらにかけないように確認が必要です。
本稿の例は入力の考え方を示すもので、運営者がこのチャットからAPIを実行した結果ではありません。
| 場所 | 内容の例 |
|---|---|
| 台本(text) | 次に、保存する場所を選びます。 |
| 話し方(speech_metadata.style) | 落ち着いた声で、初めての人へ少しゆっくり |
| 本文中のタグ | 対応する位置に <short pause> などを置く |
| 話者 | 設定済みの話者名を各発話で指定 |
できること②:1行ずつ演技をつけられる
声を決めたら、次は「どう読むか」の指示です。ここが今回のいちばんの進化だと思います。
ポイントは、台本と演技指示を分けて書くことです。
台本:読んでほしい文章そのもの。書いたとおりに、一字一句読まれます
演技指示:「落ち着いた声で、少しゆっくり」のように、その発話全体の話し方を言葉で書きます。日本語でも書けます
タグ:台本の中に <laugh>(笑い)、<sigh>(ため息)、<short pause>(短い間)などを入れると、その位置で笑い声や間が入ります。タグの文字は読まれません
相づち:|mhm| のように縦棒で囲むと、会話の聞き手の相づちになります
注意したいのは、前のモデルとの違いです。以前は台本の頭に「明るく言って:」と書く方法がありましたが、3.8では台本がそのまま読まれるため、その指示の言葉まで読み上げられることがあります。 演技指示は、必ず専用の欄に書きましょう。
ほかにも、次のようなことができます。
2人の会話:1つの台本から、2人の掛け合いを自然な間で作れます。ポッドキャスト風の解説にぴったりです。1回で使えるのは、既成の声の2人までです
長い音声:1回の出力上限16,384トークンを、公式の毎秒25トークンで換算すると約11分です。実際の読み方や上限を確認し、それより長い台本は段落ごとに分けて作ります。
できること③:自分の声を再現する
ボイスリプリケーション(声の複製)を使うと、自分の声をAIで再現できます。
必要なのは2つの録音です。
参照音声:再現したい人の、10〜30秒の自然な話し声
同じ大人の声による参照録音と同意録音を求める設計です。確認の仕組みがあることだけで、第三者の声を使う権利が自動的に得られるわけではありません。自分の声か、使用の許可を得た声を、条件に沿って扱います。
2つの声が同じ人のものかを自動で確かめるので、他人の声を勝手に複製することはできない仕組みです。子どもの声は対象外で、声の持ち主は大人であることが条件です。
また、Geminiの音声モデルで作った音声には、すべてSynthIDという聞こえない電子透かしが入ります。あとから「AIが作った音声かどうか」を確かめられるようにするためです。複製した声には、さらにC2PAという来歴情報も付きます。
なお、AI Studioでの声の複製は、欧州経済領域・イギリス・スイス・インド、米国のイリノイ州・テキサス州では使えません。日本は、この対象外の地域には入っていません。
Googleが9月23日に公表した日本語の聞き比べ
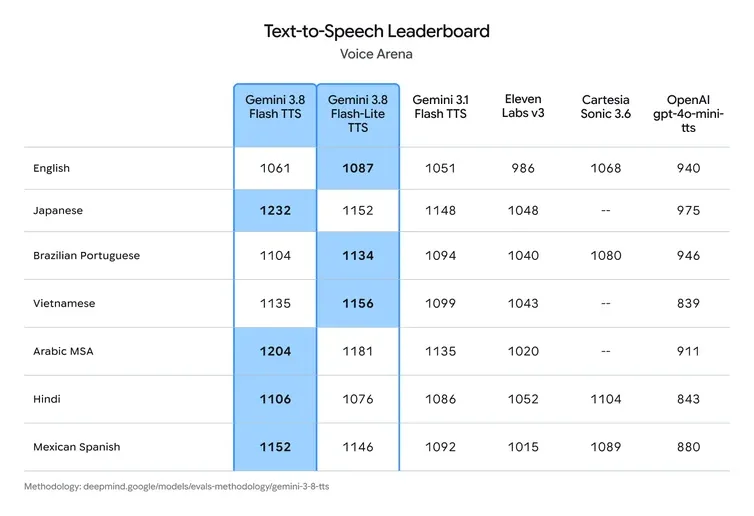
Voice Arenaは、人が2つの音声を聞き比べて、良いと思ったほうを選ぶ評価です。どのモデルの音声かは伏せたまま判定します。数字はチェスの強さの指標のような相対的な点数で、高いほど「より多く選ばれた」ことを意味します。
注目したいのは、日本語(Japanese)の行です。
Gemini 3.8 Flash TTS:1232
Gemini 3.8 Flash-Lite TTS:1152
前のモデル(Gemini 3.1 Flash TTS):1148
ElevenLabs v3:1048
OpenAI gpt-4o-mini-tts:975
Googleが2026年9月23日に掲載した表では、日本語のFlash TTSが最も高い点数です。前のモデルと比べても、はっきり差が出ています。日本語でナレーションを作りたい人にとっては、いちばん気になるところで結果が出ているのはうれしいですね。
一方で、英語ではFlash-Lite TTSのほうが点数が高く(1087)、言語によって得意なモデルが入れ替わっている点も押さえておきたいところです。
Googleが紹介した総合品質の評価
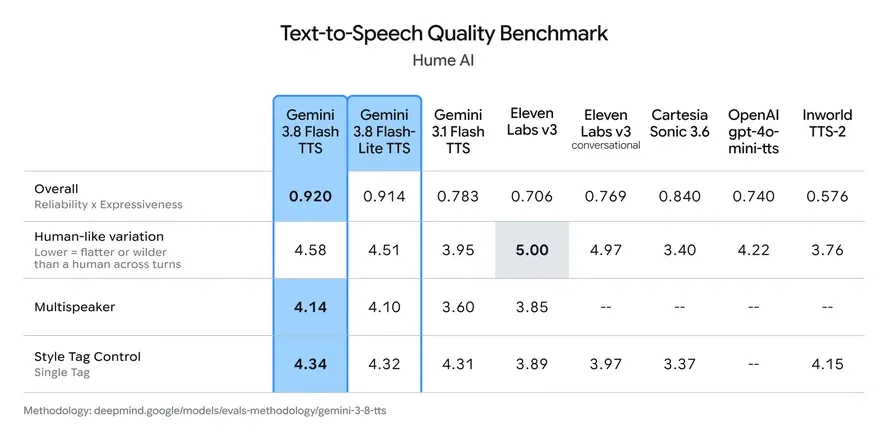
こちらは、音声AIの会社Hume AIによる評価です。「Overall(総合)」は、安定して正しく読めるか(信頼性)と、表現の豊かさをかけ合わせた点数で、Flash TTSが0.920で1位、Flash-Lite TTSが0.914で2位でした。
ただし、全部の項目で1位というわけではありません。「人間らしい揺れ(Human-like variation)」は、ElevenLabs v3が5.00で最も高くなっています。
Googleが発表に掲載した評価では、日本語と総合品質でFlash TTSが比較対象の中で高い結果を出しています。評価条件と実際の用途は異なるため、人名、数字、間の取り方などを自分の短い台本で聞き比べる材料として使います。
現在の料金と、10分の音声の計算
2026年10月2日に確認した標準API料金は、2026年12月31日まで、入力テキスト100万トークンあたり0.50米ドル、出力音声100万トークンあたり9米ドルです。2027年1月1日からは、それぞれ1米ドル、18米ドルと記載されています。
公式の換算は音声1秒あたり25トークンです。10分なら600秒×25=15,000トークンで、音声出力分は15,000÷1,000,000×9=0.135米ドルです。入力テキスト、作り直し、別のAPI利用などは追加になります。
元記事の円換算は、1回分の音声出力を、当時採用した為替で円換算した目安です。固定の販売価格ではありません。実際の費用は、生成回数、為替、料金の適用期間、無料枠の条件で確認してください。
| 対象 | 2026年12月31日まで | 2027年1月1日から |
|---|---|---|
| 入力テキスト/100万トークン | 0.50米ドル | 1米ドル |
| 出力音声/100万トークン | 9米ドル | 18米ドル |
| 10分の出力音声だけの計算 | 0.135米ドル | 0.27米ドル |
無料で試すこともできる
Google AI Studioの画面や、APIの無料枠を使えば、お試しは無料です。
ただし、無料で使う場合は、送った台本や作った音声が、Googleの製品改善に使われます。 回数にも上限があります。社外秘の資料の読み上げなど、仕事の大事な内容を扱うときは、有料枠に切り替えるのが安心です。有料枠なら、送った内容は製品改善に使われません。
解説音声:文章を直して、一部を作り直す
説明音声の修正では、間違えた箇所の台本を直して、その部分を生成する使い方が考えられます。全体を作り直す場合と、短い部分だけを生成する場合では、使うトークンと費用が変わります。
2人の掛け合い、継続して使う説明の声、別の言語での案内も用途の候補です。声を複製する場合は本人の同意と利用条件を確認し、生成した音声の名前や数字、意味が原文と合うかを聞いて確かめます。
社内資料のプレゼン:画面と音声を合わせる
社内のプレゼン資料に説明の音声を付ければ、会議に出られなかった人も、あとから見るだけで内容が分かる資料になります。
同じ換算なら、5分の音声出力分は2026年内の単価で0.0675米ドルです。入力と作り直しの料金は別に加わります。研修や操作説明の費用は、予定する生成回数を含めて見積もります。
Googleの動画作成ツール「Google Vids」には、Flash-Lite TTSが搭載されています。Googleのスライドやドキュメントを普段から使っている会社なら、いつもの道具の中で、声つきの説明動画を作れるようになっていきそうです。
小さなデモ動画:画面録画に声を足す
アプリの使い方や、新しい機能の紹介。2〜3分のデモ動画は、画面を録画して、あとから声を足すだけで作れます。
これまでは「声を入れるのが面倒だから、字幕だけで済ませる」ということも多かったと思います。費用の目安を確認できれば、声つきのデモ動画を、気軽にたくさん作れるようになります。機能が変わったら、台本を直して作り直せばいいのも楽なところです。
どの使い方でも共通して言えるのは、「一発録りの緊張」から解放されるということです。声を何度でも作り直せるので、内容を良くすることに時間を使えます。
始め方:まずはAI Studioで試してみる
いちばん手軽なのは、Google AI Studioの画面で試す方法です。プログラムを書く必要はありません。
ブラウザで Google AI Studioの音声生成の画面(aistudio.google.com/generate-speech)を開き、Googleアカウントでログインする
モデルの欄で「Gemini 3.8 Flash TTS」を選ぶ
声を選ぶか、ボイスデザインで新しい声を作る
台本と、話し方の指示を入力して、音声を作る
できた音声をその場で聞いて、気に入ったらダウンロードする
まずは、自分の動画やプレゼンの台本を1本用意して、Flash TTSとFlash-Lite TTSの両方で聞き比べてみるのがおすすめです。
使う前に知っておきたい注意点
最後に、注意点をまとめます。
無料枠の内容は、Googleの製品改善に使われる:仕事の大事な内容は有料枠で
2027年から料金が2倍:いまの料金は年末までの価格です
人名や読みが難しい言葉は、ひらがなで:とくにFlash-Liteでは読み間違いの報告があります
声の複製は、本人の同意が必須:他人の声を使うには権利が必要です
作った音声には電子透かし(SynthID)が入る:AIが作った音声であることは、あとから確かめられます
よくある疑問を、ここで。
使い始める前に、気になるところから。
「ゆっくり読んで」という指示が読み上げられるのはなぜ?
台本へ指示文を入れると、その文も読む対象になります。APIでは継続する話し方をspeech_metadata.styleへ分け、台本に実際に読ませたい内容を入れます。
10分の音声はいくらですか?
2026年内の標準API単価で、音声出力分だけなら600秒×25トークン×9米ドル÷100万=0.135米ドルです。入力・作り直し・為替・2027年からの単価変更は別に計算します。
この記事を共有する
商品情報の提供:Supported by Rakuten Developers
出典と、この記事について
公式資料や、記事で参照した発表・報道をまとめています。仕様や料金は、利用する前に最新の案内をご確認ください。
- Google公式ブログ「Gemini 3.8 text-to-speech says hello」(新しいタブで開きます)
- Gemini API(新しいタブで開きます)
- ボイスデザイン(新しいタブで開きます)
- ボイスリプリケーション(声の複製)(新しいタブで開きます)
- 公式の料金ページ(新しいタブで開きます)
- ai.google.dev: gemini-3.8-flash-tts(新しいタブで開きます)
- Dukeの元のニュース解説(新しいタブで開きます)
確認した内容と条件は本文に記載しています。結果や使い勝手は、資料や環境によって異なります。編集方針を読む
ぜひコメントください